
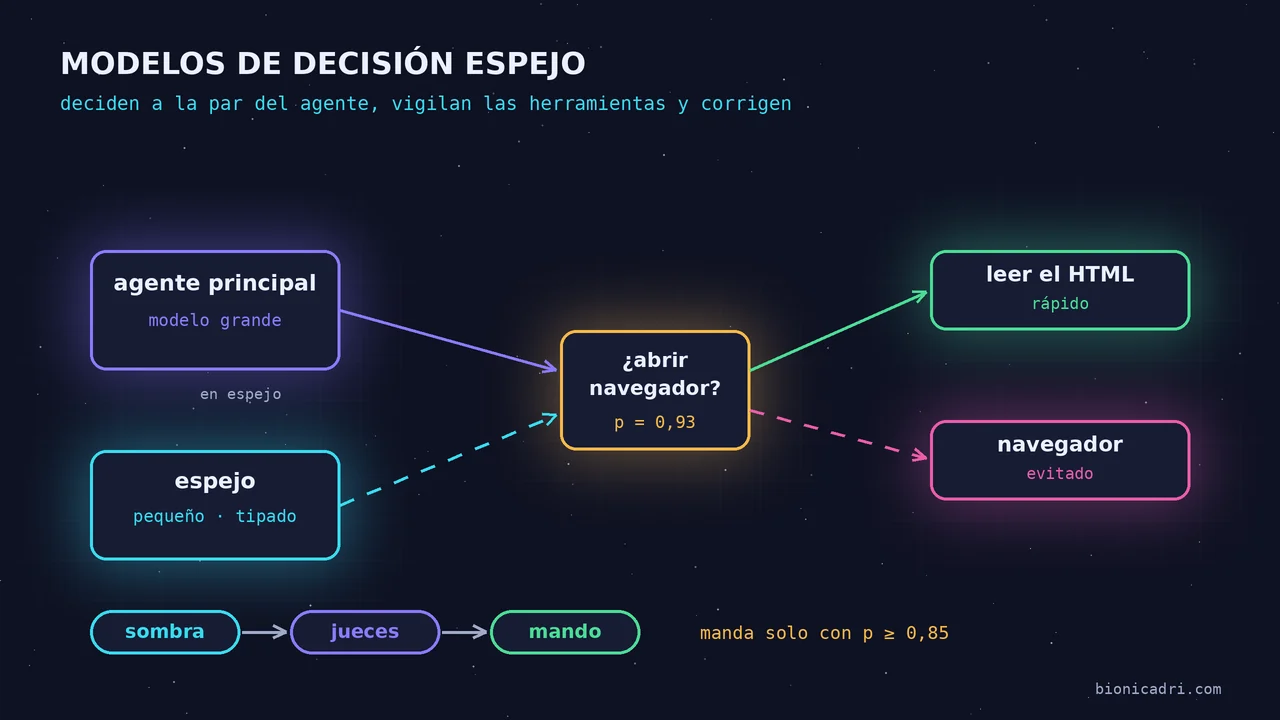
Ya contamos qué son los arneses de ADRI y qué papel juega el decisor. Aquí bajamos un nivel: cómo trabaja ese decisor «en espejo» al lado del agente, cómo frena una herramienta antes de que se ejecute, cuándo corrige al agente y en qué casos hace el paso él solo. Y cómo lo medimos antes de darle poder.
Qué es un modelo de decisión espejo
Un agente de ADRI toma decenas de decisiones pequeñas en cada tarea. ¿Esta página se lee con su HTML o hace falta abrir un navegador? ¿Este dato es de la empresa que buscamos o de otra? Antes, estas preguntas se resolvían con reglas de palabras clave escritas en el código.
El modelo espejo es un modelo pequeño y rápido que no escribe texto. Recibe dos cosas: el estado (lo que el agente tiene delante) y una pregunta tipada. Responde con una opción cerrada y una probabilidad. Hay tres tipos de pregunta: sí o no, elegir una opción de una lista y dar una puntuación. Si hay varias preguntas sobre el mismo estado, van todas en una sola llamada.
Lo de «tipada» importa. La respuesta no es un párrafo: es html_basta o necesita_js, con un 0,93 al lado. El código la valida contra las opciones permitidas; si llega otra cosa, se descarta.
Tres reglas que no se negocian
- Los hechos los decide el código. Si una herramienta se llamó, si devolvió error, si un fichero existe o qué permisos tiene el usuario: eso no se pregunta a ningún modelo. El modelo solo juzga significado.
- En seguridad, solo puede endurecer. Puede bajar un nivel, añadir un veto o pedir confirmación. Nunca puede conceder un permiso. Algunas, como la profundidad de una auditoría de seguridad, no pueden mandar nunca.
- Nada manda sin medir. Todo entra primero en sombra.
Cómo funciona la sombra
En modo sombra, el modelo espejo responde la misma pregunta que ya responde la regla del código, pero en segundo plano. El agente no le espera: la latencia que añade al usuario es cero. Si hay atasco, esa muestra se descarta en vez de frenar la tarea.
Cada decisión queda registrada: qué decidió la regla, qué decidió el modelo, con qué probabilidad y cuánto tardó. Los datos personales se tachan antes de salir. La salida del agente es idéntica con la sombra encendida o apagada.
Así acumulamos miles de casos reales, y el desacuerdo entre regla y modelo es justo lo que hay que estudiar.
Cómo se pasa de sombra a mando
Va decisión a decisión:
- Sombra con tráfico real durante días.
- Muestra: todos los desacuerdos y una parte de los acuerdos.
- Jueces: dos modelos grandes de familias distintas etiquetan cada caso por su cuenta. Solo cuenta lo que los dos etiquetan igual.
- Comparación: acierto de la regla frente a acierto del espejo cuando está seguro.
- Mando en una sola dirección, si el espejo gana con claridad.
Cuando manda, el espejo solo decide si su probabilidad llega a 0,85. Por debajo de ese umbral, o si tarda demasiado, falla o se acaba su cupo, decide la regla de siempre. Cada mando se apaga por separado desde la configuración, sin tocar código.
Un ejemplo con números. En la auditoría SEO automática, el espejo decide en qué idioma está el texto principal de cada página. Sobre 70 páginas juzgadas el 11 de octubre, la regla acertaba el 36 % y el espejo el 100 %. Desde ese día, en esa pregunta manda el espejo.
Vigilar las herramientas antes de ejecutarlas
Aquí está buena parte del ahorro: muchas herramientas son caras en tiempo o en dinero, y usarlas o no era una regla fija.
- ¿Abrir un navegador o basta con el HTML? En una tanda real del 10 de octubre, el código pedía navegador en 52 páginas; el espejo dijo en 48 que el HTML bastaba, y se ahorraron 42 navegadores. Ese día, la espera mediana para conseguir un navegador era de 142 segundos.
- ¿Qué fuentes abrir? Al investigar una empresa, el espejo clasifica cada enlace (web oficial, directorio, otra cosa) antes de abrirlo. Medido el 3 de octubre con tráfico real, cuando está seguro acierta el 97 % frente al 56 % de la regla.
- ¿Hace falta otra búsqueda? Antes de lanzar una consulta adicional, el espejo mira si el dato ya está en lo reunido.
- ¿Fue un error de formato? Cuando una herramienta falla, el sistema decide si el error fue de formato para aprender a no repetirlo. Esa lección se comparte entre tareas, así que un falso «sí» la contaminaría. Aquí el espejo tiene un veto: puede quitar un «sí» de la regla si está seguro de que es «no», pero nunca añadir uno.
Corregir al agente cuando se equivoca
El espejo también revisa lo que el agente produce. Aquí vamos con más cuidado: corregir mal es peor que no corregir.
- Datos de otra empresa. Al investigar una entidad, un dato sacado de una página (un CIF, una plantilla, un teléfono) puede ser de otra empresa que aparece en el mismo texto. El espejo decide si el dato es de la entidad buscada y quita el que no lo es. Tras rehacer la pregunta y el estado, entre el 10 y el 11 de octubre pasó del 64 % al 91 % de acierto, sin errores con confianza alta en la muestra de prueba.
- Afirmaciones sin respaldo. A la salida de todos los agentes, un juez comprueba si la respuesta dice haber enviado, publicado o verificado algo que la traza de herramientas no respalda. Hoy está en sombra: registra, no toca la respuesta.
- Progreso de la tarea. En lugar de topes fijos de llamadas, un control decide si el agente debe seguir, cambiar de enfoque o parar y entregar. Cuando mande, solo añadirá un aviso; nunca cortará la tarea. Sigue en sombra: en las primeras medidas dio falsos «cambia de enfoque» con confianza alta.
Hacer el paso él mismo
La meta es que el modelo pequeño haga pasos completos en lugar del grande, solo donde los datos lo justifican.
En la auditoría SEO ya lo hace: una sola llamada por página responde cuatro preguntas (tipo de página, si es un error disfrazado, idioma e imagen decorativa). En una segunda web, una tienda online que no se usó para escribir las preguntas, acertó el 99 % en el tipo de página frente al 84 % de la regla.
En el navegador, todavía no conduce. Ya tenemos la pregunta preparada: qué operación toca (pulsar, escribir, desplazarse, terminar…) y sobre qué elemento. En las primeras medidas discrepaba demasiado con el agente, así que empezaremos por los pasos triviales.
A veces medir dice que no. En el planificador medimos 30 días de tareas: el tiempo era el modelo grande razonando, no pasos mecánicos. No había nada que quitarle y no se construyó.
Cuánto se ahorra
- Tiempo de punta a punta. El 5 y 6 de octubre repetimos 11 tareas reales tres veces, con los mandos encendidos y apagados. Con mandos tardaron 863 segundos en total; sin ellos, 1.124 (un 23 % menos). La calidad, juzgada a ciegas, salió igual. En tareas muy simples, los mandos añadieron entre 2 y 13 segundos.
- Una tanda de investigación. Con el mismo encargo, el 10 de octubre pasó de 17 minutos a 5 minutos y 46 segundos, y las llamadas al modelo principal de 71 a 36. Ojo: esa mejora suma los mandos y otros arreglos del mismo día, como más navegadores en paralelo.
- Coste del propio espejo. Entre el 29 de septiembre y el 1 de octubre, 3.618 decisiones costaron 0,043 dólares en total. En el servidor, cada decisión tarda unos 63 milisegundos de media; pasando por nuestro gateway, entre 0,3 y 0,9 segundos.
Límites y estado actual
- El modelo pequeño también falla. La diferencia es que su fallo queda registrado y medido, y que por debajo del umbral decide la regla.
- Cuando falla con seguridad, suele faltarle información. Si los jueces aciertan con el mismo texto y el espejo no, falla el estado que le damos; si el espejo duda, suele fallar la pregunta.
- La mayoría sigue en sombra. Entre el 8 y el 11 de octubre registramos 74 puntos de decisión. En nuestro servidor central mandan 16. En una instalación nueva, el espejo llega apagado y se enciende cuando se decide.
- No sustituye la revisión. Lo importante lo sigue validando una persona.
Cómo protegemos los datos por el camino lo contamos en seguridad y cumplimiento. Para ver a los especialistas trabajando, mira qué hace ADRI o pruébalo en el chat con ADRI.
- Agentes IA
- Decisiones tipadas
- Modo sombra
- ADRI