
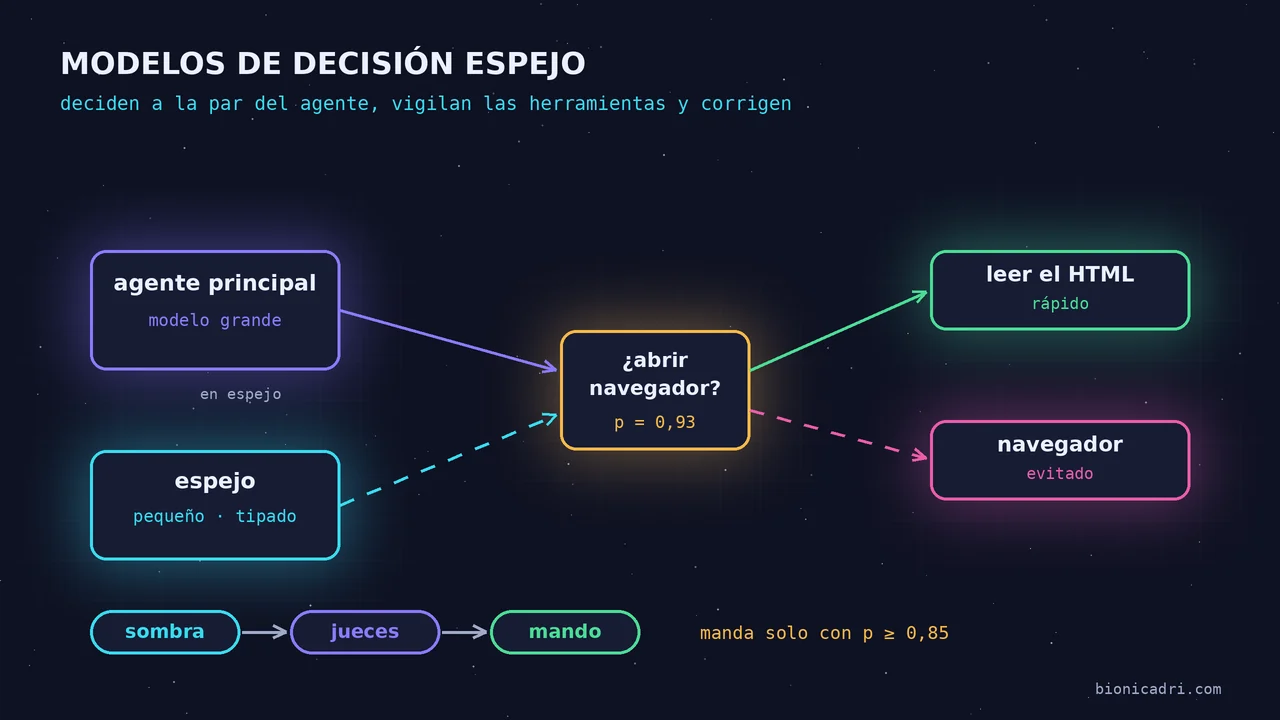
Wir haben bereits beschrieben, was die Harnesse von ADRI sind und welche Rolle der Entscheider spielt. Hier gehen wir eine Ebene tiefer: wie dieser Entscheider „im Spiegel“ an der Seite des Agenten arbeitet, wie er ein Tool bremst, bevor es ausgeführt wird, wann er den Agenten korrigiert und in welchen Fällen er den Schritt selbst macht. Und wie wir ihn messen, bevor wir ihm Macht geben.
Was ist ein Spiegel-Entscheidungsmodell
Ein ADRI-Agent trifft bei jeder Aufgabe Dutzende kleiner Entscheidungen. Wird diese Seite mit ihrem HTML gelesen oder muss ein Browser geöffnet werden? Gehört diese Information zu dem Unternehmen, das wir suchen, oder zu einem anderen? Früher wurden diese Fragen mit Keyword-Regeln gelöst, die im Code geschrieben waren.
Das Spiegelmodell ist ein kleines, schnelles Modell, das keinen Text schreibt. Es erhält zwei Dinge: den Status (das, was der Agent vor sich hat) und eine typisierte Frage. Es antwortet mit einer geschlossenen Option und einer Wahrscheinlichkeit. Es gibt drei Fragetypen: Ja oder Nein, eine Option aus einer Liste wählen und eine Punktzahl vergeben. Wenn es mehrere Fragen zum selben Status gibt, gehen alle in einen einzigen Aufruf.
Das mit „typisiert“ ist wichtig. Die Antwort ist kein Absatz: Sie ist html_basta oder necesita_js, mit einer 0,93 daneben. Der Code validiert sie gegen die erlaubten Optionen; kommt etwas anderes, wird es verworfen.
Drei Regeln, die nicht verhandelbar sind
- Fakten entscheidet der Code. Ob ein Tool aufgerufen wurde, ob es einen Fehler zurückgab, ob eine Datei existiert oder welche Berechtigungen der Nutzer hat: Das wird kein Modell gefragt. Das Modell beurteilt nur Bedeutung.
- In puncto Sicherheit kann es nur verschärfen. Es kann eine Stufe herunterstufen, ein Veto hinzufügen oder eine Bestätigung verlangen. Niemals kann es eine Berechtigung erteilen. Manche – wie die Tiefe eines Sicherheitsaudits – dürfen niemals entscheiden.
- Nichts hat das Sagen ohne Messung. Alles geht zuerst in den Schatten.
Wie der Schatten funktioniert
Im Schattenmodus beantwortet das Spiegelmodell dieselbe Frage, die bereits die Regel des Codes beantwortet, aber im Hintergrund. Der Agent wartet nicht auf es: Die Latenz, die es dem Nutzer hinzufügt, ist null. Bei einem Stau wird diese Stichprobe verworfen, anstatt die Aufgabe zu bremsen.
Jede Entscheidung wird aufgezeichnet: Was die Regel entschied, was das Modell entschied, mit welcher Wahrscheinlichkeit und wie lange es dauerte. Personenbezogene Daten werden vor der Ausgabe geschwärzt. Die Ausgabe des Agenten ist identisch, ob der Schatten ein- oder ausgeschaltet ist.
So sammeln wir Tausende echte Fälle, und die Uneinigkeit zwischen Regel und Modell ist genau das, was untersucht werden muss.
Wie man vom Schatten zur Steuerung übergeht
Es geht Entscheidung für Entscheidung:
- Schatten mit echtem Traffic über Tage.
- Stichprobe: alle Uneinigkeiten und ein Teil der Übereinstimmungen.
- Richter: Zwei große Modelle aus verschiedenen Familien etikettieren jeden Fall eigenständig. Es zählt nur, was beide gleich etikettieren.
- Vergleich: Trefferquote der Regel gegenüber Trefferquote des Spiegels, wenn er sicher ist.
- Steuerung in eine einzige Richtung, wenn der Spiegel klar gewinnt.
Wenn er das Sagen hat, entscheidet der Spiegel nur, ob seine Wahrscheinlichkeit 0,85 erreicht. Unterhalb dieser Schwelle, oder wenn er zu lange braucht, fehlschlägt oder sein Kontingent erschöpft ist, entscheidet die übliche Regel. Jede Steuerung lässt sich separat in der Konfiguration abschalten, ohne Code zu ändern.
Ein Beispiel mit Zahlen. In der automatischen SEO-Prüfung entscheidet der Spiegel, in welcher Sprache der Haupttext jeder Seite ist. Bei 70 am 11. Oktober beurteilten Seiten lag die Regel bei 36 % und der Spiegel bei 100 %. Seit diesem Tag hat der Spiegel bei dieser Frage das Sagen.
Tools vor der Ausführung überwachen
Hier liegt ein großer Teil der Einsparung: Viele Tools sind teuer in Zeit oder Geld, und ob man sie nutzt oder nicht, war eine feste Regel.
- Einen Browser öffnen oder reicht HTML? In einer echten Runde am 10. Oktober forderte der Code für 52 Seiten einen Browser an; der Spiegel sagte bei 48, dass HTML ausreichte, und es wurden 42 Browser eingespart. An diesem Tag betrug die mediane Wartezeit für einen Browser 142 Sekunden.
- Welche Quellen öffnen? Bei der Untersuchung eines Unternehmens klassifiziert der Spiegel jeden Link (offizielle Website, Verzeichnis, etwas anderes), bevor er ihn öffnet. Am 3. Oktober mit echtem Traffic gemessen, liegt er bei Sicherheit bei 97 % Trefferquote gegenüber 56 % der Regel.
- Ist eine weitere Suche nötig? Bevor eine zusätzliche Abfrage gestartet wird, prüft der Spiegel, ob die Information bereits in dem Gesammelten enthalten ist.
- War es ein Formatfehler? Wenn ein Tool fehlschlägt, entscheidet das System, ob der Fehler ein Formatfehler war, um zu lernen, ihn nicht zu wiederholen. Diese Lektion wird zwischen Aufgaben geteilt, sodass ein falsches „Ja“ sie verfälschen würde. Hier hat der Spiegel ein Veto: Er kann ein „Ja“ aus der Regel entfernen, wenn er sicher ist, dass es „Nein“ lautet, aber niemals eines hinzufügen.
Den Agenten korrigieren, wenn er sich irrt
Der Spiegel überprüft auch, was der Agent produziert. Hier gehen wir vorsichtiger vor: falsch korrigieren ist schlimmer als nicht korrigieren.
- Daten eines anderen Unternehmens. Bei der Untersuchung einer Entität kann ein von einer Seite entnommenes Datum (ein CIF, eine Vorlage, eine Telefonnummer) von einem anderen Unternehmen stammen, das im selben Text erscheint. Der Spiegel entscheidet, ob das Datum von der gesuchten Entität stammt, und entfernt das, was nicht dazugehört. Nach Überarbeitung der Frage und des Zustands stieg er zwischen dem 10. und 11. Oktober von 64 % auf 91 % Trefferquote, ohne Fehler mit hoher Konfidenz in der Teststichprobe.
- Unbelegte Behauptungen. Am Ausgang aller Agenten prüft ein Richter, ob die Antwort behauptet, etwas gesendet, veröffentlicht oder verifiziert zu haben, was die Werkzeugspur nicht stützt. Heute ist er im Schattenmodus: Er protokolliert, berührt die Antwort nicht.
- Aufgabenfortschritt. Anstelle fester Aufrufobergrenzen entscheidet eine Steuerung, ob der Agent fortfahren, den Ansatz wechseln oder anhalten und liefern soll. Wenn sie das Sagen hat, fügt sie nur einen Hinweis hinzu; sie wird die Aufgabe nie abbrechen. Sie bleibt im Schattenmodus: In den ersten Messungen gab sie falsche „Ansatz wechseln“ mit hoher Konfidenz aus.
Den Schritt selbst ausführen
Das Ziel ist, dass das kleine Modell vollständige Schritte anstelle des großen macht, nur wo die Daten es rechtfertigen.
Im SEO-Audit tut es das bereits: Ein einzelner Aufruf pro Seite beantwortet vier Fragen (Seitentyp, ob es ein getarnter Fehler ist, Sprache und dekoratives Bild). Bei einer zweiten Website, einem Onlineshop, der nicht zum Schreiben der Fragen verwendet wurde, lag es beim Seitentyp zu 99 % richtig gegenüber 84 % der Regel.
Im Browser führt es noch nicht. Wir haben die Frage bereits vorbereitet: Welche Operation ansteht (klicken, schreiben, scrollen, beenden …) und auf welches Element. In den ersten Messungen wich es zu stark vom Agenten ab, also beginnen wir mit den trivialen Schritten.
Manchmal sagt das Messen nein. Im Planer maßen wir 30 Tage Aufgaben: Die Zeit war das große Modell, das nachdachte, nicht mechanische Schritte. Es gab nichts zu entfernen, und es wurde nicht gebaut.
Wie viel gespart wird
- End-to-End-Zeit. Am 5. und 6. Oktober wiederholten wir 11 reale Aufgaben dreimal, mit den Steuerungen an- und ausgeschaltet. Mit Steuerungen dauerten sie insgesamt 863 Sekunden; ohne sie 1.124 (23 % weniger). Die Qualität, blind bewertet, war gleich. Bei sehr einfachen Aufgaben fügten die Steuerungen zwischen 2 und 13 Sekunden hinzu.
- Eine Forschungsrunde. Mit demselben Auftrag ging es am 10. Oktober von 17 Minuten auf 5 Minuten und 46 Sekunden zurück, und die Aufrufe an das Hauptmodell von 71 auf 36. Achtung: Diese Verbesserung umfasst die Steuerungen und andere Korrekturen desselben Tages, wie mehr parallele Browser.
- Kosten des Spiegels selbst. Zwischen dem 29. September und dem 1. Oktober kosteten 3.618 Entscheidungen insgesamt 0,043 US-Dollar. Auf dem Server dauert jede Entscheidung durchschnittlich etwa 63 Millisekunden; über unser Gateway zwischen 0,3 und 0,9 Sekunden.
Grenzen und aktueller Stand
- Auch das kleine Modell schlägt fehl. Der Unterschied ist, dass sein Fehler registriert und gemessen wird und dass unterhalb der Schwelle die Regel entscheidet.
- Wenn es sicher fehlschlägt, fehlt ihm meistens Information. Wenn die Richter mit demselben Text richtig liegen und der Spiegel nicht, liegt es am Zustand, den wir ihm geben; wenn der Spiegel zweifelt, liegt es meistens an der Frage.
- Die Mehrheit bleibt im Schattenmodus. Zwischen dem 8. und 11. Oktober registrierten wir 74 Entscheidungspunkte. Auf unserem zentralen Server haben 16 das Sagen. Bei einer Neuinstallation kommt der Spiegel ausgeschaltet und wird eingeschaltet, wenn entschieden wird.
- Es ersetzt nicht die Prüfung. Das Wichtige wird weiterhin von einer Person validiert.
Wie wir die Daten unterwegs schützen, erzählen wir in Sicherheit und Compliance. Um die Spezialisten bei der Arbeit zu sehen, schau dir was ADRI macht an oder teste es im Chat mit ADRI.
- KI-Agenten
- Typisierte Entscheidungen
- Schattenmodus
- ADRI