
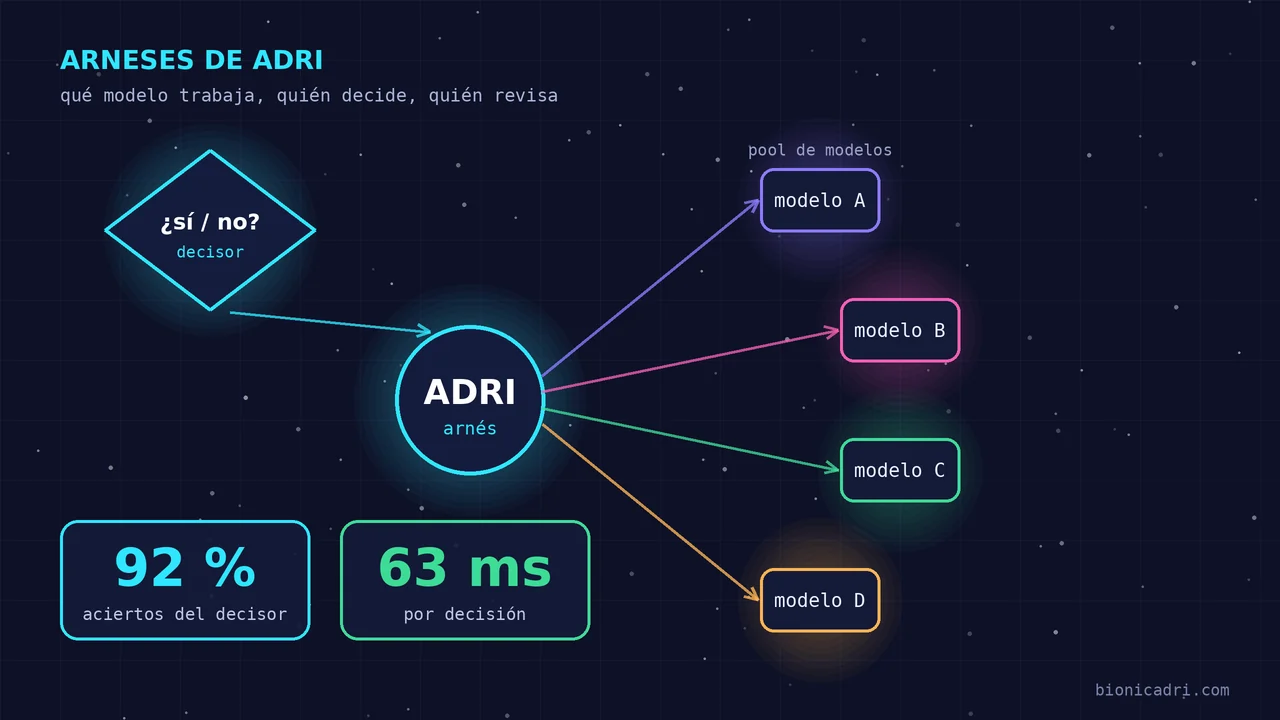
Was ein „Harness“ ist und warum es wichtig ist
Wenn du eine sehr kluge Person einstellst, gibst du ihr nicht nur einen Computer. Du gibst ihr eine Stelle, einen Chef, Regeln, ein Budget und jemanden, der das Wichtige prüft. Mit künstlicher Intelligenz ist es genauso.
Das Harness ist alles, was das KI-Modell umgibt: welches Modell jeder Spezialist verwendet, wie die Anfragen verteilt werden, was wiederholt wird, was entschieden wird und wann gestoppt wird. Das Modell liefert die Intelligenz; das Harness liefert das Urteilsvermögen und die Sicherheit.
ADRI, das Team der Spezialisten von BionicAdri, funktioniert so. Hier erklären wir dir, wie – ohne Fachjargon.
Wer an welcher Aufgabe arbeitet: der Teamleiter
Jeder Spezialist von ADRI fordert Arbeit von einer Modellgruppe an, die wir „Pool“ nennen, und zwar über ein eigenes Gateway. Stell dir das Gateway als Teamleiter vor, der die Aufgaben unter den verfügbaren Mitarbeitern verteilt.
Seit dem 19. September wählt ADRI das Modell nicht mehr manuell aus. Das übernimmt das Gateway mit drei einfachen Regeln:
- Nach Priorität. Zuerst werden die bevorzugten Modelle aufgerufen.
- Bei gleicher Priorität: am wenigsten ausgelastet. Wie an einer Supermarktkasse: Man stellt dich dorthin, wo die Schlange am kürzesten ist.
- Springe zu den vollen oder ausgefallenen, bevor mit dem Antworten begonnen wird, damit niemand auf ein Modell wartet, das nicht antworten wird.
Außerdem geht die Abrechnung nur an das Modell, das geantwortet hat. Wenn eines ausgefallen war und übersprungen wurde, kostet es nichts.
Als Hauptmodell verwenden wir Qwen, Open Source.
Weniger Stufen, mehr Klarheit
Früher gab es drei Qualitätsstufen: niedrig, normal und hoch. Am 7. September haben wir sie entfernt, weil beim Messen zwei davon auf dasselbe Modell entfielen: Das war Komplexität ohne Nutzen. Heute gibt es einen Pool pro Spezialist. Die Live-Stimme hat ihren eigenen, und dort zählt die Antwortgeschwindigkeit.
Was passiert, wenn ein Modell ausfällt
Modelle machen manchmal Fehler auf sehr konkrete Weise: Die Antwort bricht mitten im Satz ab, oder das Modell wiederholt immer dasselbe in einer Schleife.
In diesem Fall gibt ADRI nicht auf und liefert dir keine halbe Antwort. Er fordert die Arbeit von einem anderen Modell der Gruppe an, wie ein Chef, der, wenn ein Mitarbeiter blockiert ist, die Aufgabe an einen Kollegen weitergibt. Es gibt eine Grenze: maximal zwei Sprünge pro Anfrage, damit ein Problem nicht zu einer endlosen Kette wird.
Die kleinen Entscheidungen: der Schiedsrichter
Ein System mit vielen Spezialisten trifft Hunderte kleine Entscheidungen: An wen geht diese Anfrage? Welche Methode nutze ich, um diese Daten zu suchen? Früher wurden sie mit starren Keyword-Regeln gelöst: „Wenn die Nachricht dieses Wort enthält, geht sie dorthin“. Sie funktionieren, bis jemand sich anders ausdrückt.
Dafür hat ADRI einen Entscheider, ein kleines Modell (rund 9 Milliarden Parameter), das keine Texte schreibt. Es ist wie ein Schiedsrichter: Es beantwortet nur Ja/Nein-Fragen oder wählt zwischen Optionen und sagt, mit welcher Wahrscheinlichkeit es das denkt. Es ersetzt die Keyword-Regeln in rund 36 Entscheidungen des Systems.
Wie er Schritt für Schritt eingeführt wurde
- Im Schattenmodus. Der Entscheider notiert nur, was er entschieden hätte und ob es mit der alten Regel übereinstimmt. Er sendet nichts.
- Tage mit echtem Traffic. Man lässt ihn echte Arbeit beobachten, bevor er Macht bekommt.
- Entscheidung für Entscheidung. Sie wird eine nach der anderen aktiviert, nicht alle auf einmal.
Was die Sicherheit angeht, hat er außerdem die Hände gebunden: Er kann nur verschärfen, niemals erlauben. Wenn er Zweifel hat, kann sein Veto nur ein „Ja“ entfernen, niemals hinzufügen.
Was wir messen
Auf Basis eines Pools von 526 realen Fällen:
| Entscheider | Trefferquote |
|---|---|
| Vorher | 89 % |
| Aktuell | 92-93 % |
Und es geht schnell: durchschnittlich etwa 63 Millisekunden pro Entscheidung. Wenn es zweifelt (geringe Konfidenz), kann es ein größeres Modell konsultieren. Aber auch das haben wir gemessen: Mit blinden Richtern haben wir am 9. Oktober aufgehört, den Text zu eskalieren, weil das kleine Modell öfter richtig lag (10 gegenüber 6 in den Fällen, in denen sie sich unterschieden). Manchmal ist das große nicht besser als das kleine.
Ein Beispiel aus der Praxis
Am 9. Oktober haben wir etwas am Supervisor geändert: Er schickt nicht mehr «zur Programmierung», was nicht weiß, wo es hingehört. In 14 Tagen sahen wir, dass 22 von 73 Aufträgen an die Programmierung einfach «lies diese Datei» waren. Jetzt löst es, wer zuständig ist, und die Programmierung kümmert sich ums Programmieren.
Ohne feste Limits: eine Fortschrittskontrolle
Am 4. Oktober haben wir die festen Arbeitslimits entfernt. Vorher wurde eine Aufgabe nach X Aufrufen abgebrochen, ob es sinnvoll war oder nicht. Es war, als würde man einem Mitarbeiter sagen: «Um 15 Uhr hörst du mit dem auf, was du gerade machst».
Jetzt bewertet eine Fortschrittskontrolle, ob es sich lohnt weiterzumachen, den Ansatz zu ändern oder zu stoppen und das Gesammelte abzugeben. Im Gateway bleibt ein Ausgabenlimit pro Aufgabe als Sicherung: Falls etwas außer Kontrolle gerät, haben die Kosten eine Grenze.
Wie mehrere Modelle die Arbeit überprüfen
Für Code, Sicherheit und heikle Bereiche kann ADRI mehrere Modelle aus verschiedenen Familien parallel starten, jedes mit seinem eigenen Fokus, und zusammenführen, was sie finden. Es ist, als würde man mehrere unabhängige Prüfer um ihre Meinung bitten, die sich vorher nicht abgesprochen haben.
Warum verschiedene Familien? Weil jede auf andere Weise Fehler macht. Was eine übersieht, sieht eine andere.
Eine einzelne Meinung genügt nicht; Übereinstimmung schon
In einer internen Messung von 1.112 Befunden:
- Ein isolierter Hinweis von nur einem Modell liegt in 16-25 % der Fälle richtig.
- Wenn 3 oder 4 Familien übereinstimmen, liegt die Trefferquote bei rund 90 %.
Deshalb zählt die Übereinstimmung, nicht die Warnung eines Einzelnen. Und das Wichtige prüft immer ein Mensch.
Eine Lektion aus dem JuliEin Benchmark vom 11. Juli lehrte uns etwas Nützliches: vier Modelle zusammenzunehmen «hebt den Boden» (filtert Fehler), aber nicht «die Decke» (macht sie nicht klüger). Es hilft, sich weniger zu irren, nicht, ein Genie zu sein.
Was das für dein Unternehmen bedeutet
- Weniger Überraschungen. Wenn ein Modell ausfällt, setzt ein anderes die Arbeit fort.
- Gemessene Entscheidungen. Jede Änderung wurde vor der Aktivierung getestet, mit Zahlen.
- Sicherheit durch Design. In heiklen Bereichen kann das System nur Türen schließen.
- Ausgabenkontrolle. Ein Limit pro Aufgabe verhindert unerwartete Kosten.
- Ein Mensch am Ende. Die KI schlägt vor und filtert; das Wichtige wird von jemandem validiert.
Fazit
Die Intelligenz eines Assistenten steckt nicht nur im Modell. Sie steckt darin, wie die Arbeit verteilt wird, wie auf Fehler reagiert wird, wer Zweifelsfälle entscheidet und wer prüft. Das ist der Teil, den wir bei BionicAdri bauen.
Wenn du ADRI mit den Daten deines Unternehmens arbeiten sehen möchtest, fordere eine Demo an oder schreib uns an [email protected].
- KI-Agenten
- Modell-Gateway
- Entscheider
- Multimodell-Überprüfung
Wenn du sehen möchtest, wie die Modelle, die jeden Schritt überwachen, intern funktionieren, lies Spiegel-Entscheidungsmodelle: wie ADRI entscheidet, überwacht und sich korrigiert.