
Wenn du ADRI bittest, ein Angebot vorzubereiten, deine E-Mails zu prüfen oder einen Kunden im CRM zu aktualisieren, liest sie nicht nur einmal. Sie arbeitet in Schritten: lesen, ein Tool verwenden, das Ergebnis lesen und erneut nachdenken. Und bei jedem Schritt liest die KI das Vorherige erneut. Dieser wiederholte Text ist teuer, und der Cache existiert, damit du ihn nicht jedes Mal vollständig bezahlen musst.
Die Zahlen in diesem Artikel sind eigene Messungen von BionicAdri, die auf unserer Plattform seit Beginn unserer Cache-Messungen Ende August 2026 erhoben wurden.
Was ADRI bei jedem Schritt liest
Wenn ADRI sich an eine Aufgabe macht, erhält die KI immer ein Textpaket. Darin enthalten sind ihre Anweisungen, die Tools, die sie verwenden kann, der Kontext deines Unternehmens, der Verlauf dessen, was bereits erledigt wurde, und schließlich deine konkrete Anfrage.
Von einem Schritt zum nächsten ist fast das ganze Paket identisch. Es ändert sich wenig: das letzte Ergebnis eines Tools oder der nächste Satz der Konversation. Dasselbe jedes Mal von Null an neu zu lesen, wäre, als würde man einen Mitarbeiter bitten, vor jedem Anruf das gesamte Unternehmenshandbuch erneut zu lesen.
Was der Cache ist, mit einem einfachen Bild
Der Cache ist ein Kurzzeitgedächtnis des KI-Anbieters. Wenn der Anfang des Textes gleich ist wie vor wenigen Augenblicken, erkennt der Anbieter ihn, verarbeitet ihn nicht erneut und berechnet ihn viel günstiger. Er arbeitet nur mit dem, was neu ist, noch einmal.
Denk an einen Aktenschrank mit dem bereits geöffneten Ordner deines Kunden auf dem Tisch. Du nimmst ihn nicht heraus, blätterst nicht noch einmal darin: Du hast ihn griffbereit und fügst nur das neue Blatt hinzu.
Wie viel günstiger es ist
Im öffentlichen Tarif von BionicAdri kostet eine Million Eingabe-Tokens 0,585 € und eine Million aus dem Cache 0,06 €. Das ist fast 10-mal weniger. Wenn du nicht weißt, was ein Token ist, wird es im Abschnitt Sitze und Tokens der Preisseite erklärt, mit Eingabe, Ausgabe und Cache.
| Wie man es liest | Preis pro Million Tokens |
|---|---|
| Normale Eingabe | 0,585 € |
| Aus dem Cache bedient | 0,06 € |
Wie viel Cache tatsächlich genutzt wird
Dass der Cache existiert, reicht nicht: Man muss erreichen, dass er genutzt wird. Das haben wir gemessen:
- Woche für Woche werden seit September 2026 zwischen 63 % und 71 % aller Eingabe-Tokens aus dem Cache bedient.
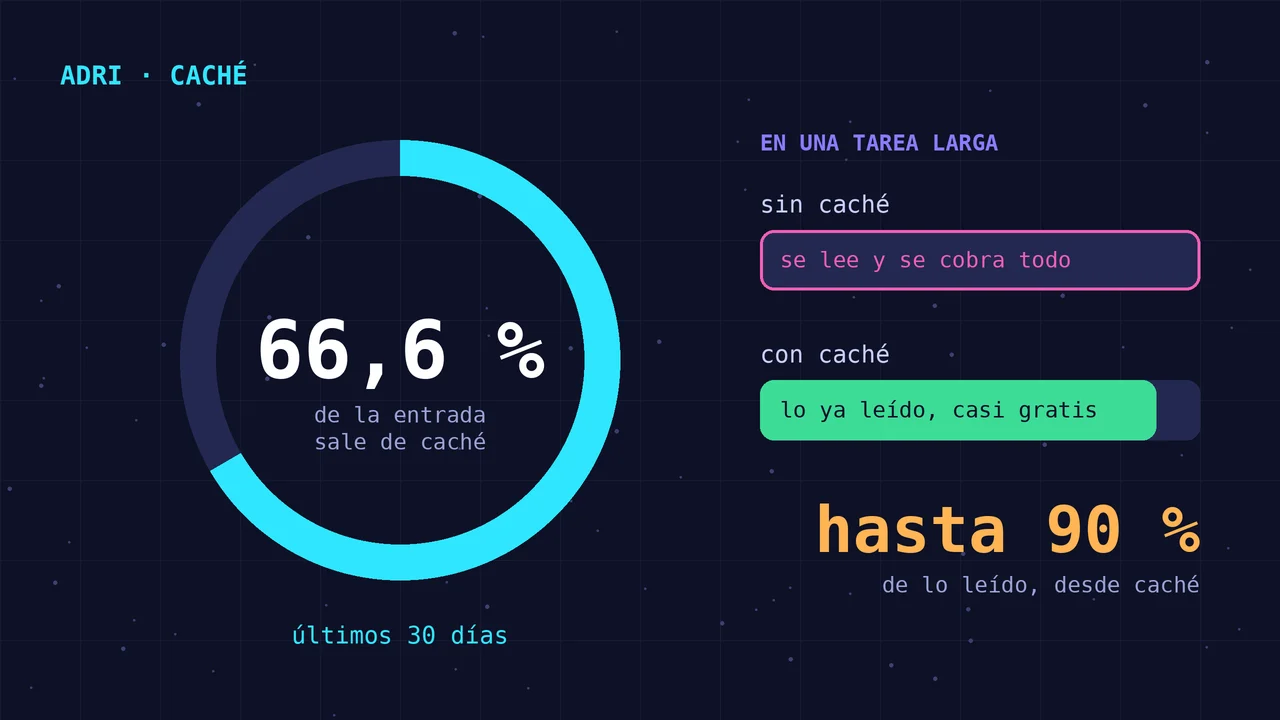
- In den letzten 30 Tagen kamen 66,6 % von etwa 1.000 Millionen Eingabe-Tokens aus dem Cache, verteilt auf 10.299 Aufgaben. Die gemessene Ersparnis beträgt etwa 344 €.
Und pro Aufgabe sieht die Verteilung so aus:
| Welche Aufgaben | Anteil, der aus dem Cache kommt |
|---|---|
| Mindestens die Hälfte der Aufgaben | 76 % |
| Die besten 10 % | 87 % |
| Lange Aufgaben | bis zu 90 % |
5 % der Aufgaben überschreiten 90 %, und der Höchstwert, den wir beobachtet haben, liegt bei 92,5 %. Lange Aufgaben gewinnen am meisten, weil bei ihnen am häufigsten erneut gelesen wird.
Eine wichtige Klarstellung: Die 90 % sind kein Rabatt von 90 % auf deiner Rechnung. Es ist der Anteil dessen, was die KI liest, der bei langen Aufgaben aus dem Cache kommt. Dieser Anteil wird viel günstiger berechnet, aber der Rest der Kosten der Aufgabe, etwa das, was die KI schreibt, bleibt wie er ist.
Wie wir das erreichen
Der Anbieter erkennt nur den Anfang des Textes wieder. Wenn sich am Beginn etwas ändert, passt es nicht mehr zusammen und alles wird erneut berechnet. Deshalb ist die Reihenfolge wichtig.
Wir ordnen das, was die KI liest, folgendermaßen:
- Zuerst das Stabile: die Anweisungen, die Werkzeuge und der Unternehmenskontext, immer in derselben Reihenfolge.
- Am Ende das, was sich ändert: die neue Anfrage und die neuesten Ergebnisse.
So bleibt von einem Schritt zum nächsten der Anfang identisch, und der Anbieter erkennt ihn wieder. Nur der letzte Teil wird erneut verarbeitet. Das ist eher Arbeit an Ordnung und Disziplin als Magie, und es macht sich täglich bemerkbar.
Was du gewinnst
- Weniger Kosten pro Aufgabe. Das ist einer der Gründe, warum die KI in Tarifen pro Arbeitsplatz mit fester Gebühr enthalten sein kann.
- Antworten, die früher beginnen. Was bereits gelesen wurde, muss nicht erneut verarbeitet werden.
- Das gleiche Ergebnis. Der Cache ändert nicht, was die KI antwortet: Er ändert, was das Lesen kostet.
Ein Beispiel zur Veranschaulichung
Stell dir vor, du bittest ADRI, die offenen Rechnungen eines Kunden zu prüfen und dir eine Mahn-E-Mail vorzubereiten. Dafür konsultiert sie das ERP, liest die Kundenhistorie, prüft die Daten und verfasst den Text. Das sind mehrere aufeinanderfolgende Schritte.
Bei jedem Schritt sind die Anweisungen von ADRI, ihre Werkzeuge und der Kontext deines Unternehmens dieselben. Mit dem Cache wird dieser Teil einmal gelesen und in den folgenden Schritten wiederverwendet. Ohne ihn würde er jedes Mal erneut gelesen und berechnet. Je mehr Schritte eine Aufgabe hat, desto stärker fällt der Unterschied auf, und deshalb kommen die langen Aufgaben dem Wert von 90 % am nächsten.
Kurz gesagt
ADRI erledigt Arbeit, und Arbeiten bedeutet, erneut zu lesen. Dank des Caches kamen in den letzten 30 Tagen 66,6 % von dem, was gelesen wurde, aus dem Cache, statt erneut verarbeitet zu werden, und bei langen Aufgaben liegt der Anteil bei bis zu 90 %. Für dich bedeutet das günstigere und schnellere Aufgaben bei gleicher Qualität.
Wenn du verstehen möchtest, wie die Arbeit zwischen Spezialisten aufgeteilt wird, lies wie das Agentensystem von ADRI funktioniert. Und wenn du Fragen zu Zahlen oder Tarifen hast, schreib uns an [email protected].
- Cache
- Tokens
- Kosten der KI
- ADRI