
Se chiedi ad ADRI di preparare un preventivo, controllare la tua email o aggiornare un cliente nel CRM, non fa una sola lettura. Lavora per passaggi: legge, usa uno strumento, legge il risultato e ripensa. E a ogni passaggio l'IA rilegge quanto precede. Quel testo ripetuto è costoso, e la cache esiste per non fartelo pagare intero ogni volta.
I numeri di questo articolo sono misurazioni proprie di BionicAdri, prese sulla nostra piattaforma da quando abbiamo iniziato a misurare la cache, alla fine di agosto 2026.
Cosa legge ADRI a ogni passaggio
Quando ADRI si mette al lavoro su un'attività, l'IA riceve sempre un pacchetto di testo. Dentro ci sono le sue istruzioni, gli strumenti che può usare, il contesto della tua azienda, la cronologia di ciò che ha già fatto e, alla fine, la tua richiesta specifica.
Da un passaggio all'altro, quasi tutto quel pacchetto è identico. Cambia poco: l'ultimo risultato di uno strumento o la frase successiva della conversazione. Rileggere sempre lo stesso da zero ogni volta sarebbe come chiedere a un dipendente che, prima di ogni chiamata, si rileggesse l'intero manuale aziendale.
Cos'è la cache, con un'immagine semplice
La cache è una memoria a breve termine del fornitore dell'IA. Se l'inizio del testo è uguale a quello di qualche istante fa, il fornitore lo riconosce, non lo rielabora e lo fa pagare molto meno. Lavora di nuovo solo su ciò che è nuovo.
Pensa a un archivio con la cartella del tuo cliente già aperta sul tavolo. Non la tiri fuori, non la sfogli di nuovo: la hai a portata di mano e aggiungi solo il foglio nuovo.
Quanto costa meno
Nella tariffa pubblica di BionicAdri, un milione di token di input costa 0,585 € e un milione servito dalla cache costa 0,06 €. È quasi 10 volte meno. Se non sai cos'è un token, è spiegato nella sezione Posti e token della pagina dei prezzi, con input, output e cache.
| Come si legge | Prezzo per milione di token |
|---|---|
| Input normale | 0,585 € |
| Servito dalla cache | 0,06 € |
Quanta cache si sfrutta davvero
Che la cache esista non basta: bisogna riuscire a farla usare. Questo è ciò che abbiamo misurato:
- Settimana dopo settimana, da settembre 2026, tra il 63 % e il 71 % di tutti i token di input vengono serviti dalla cache.
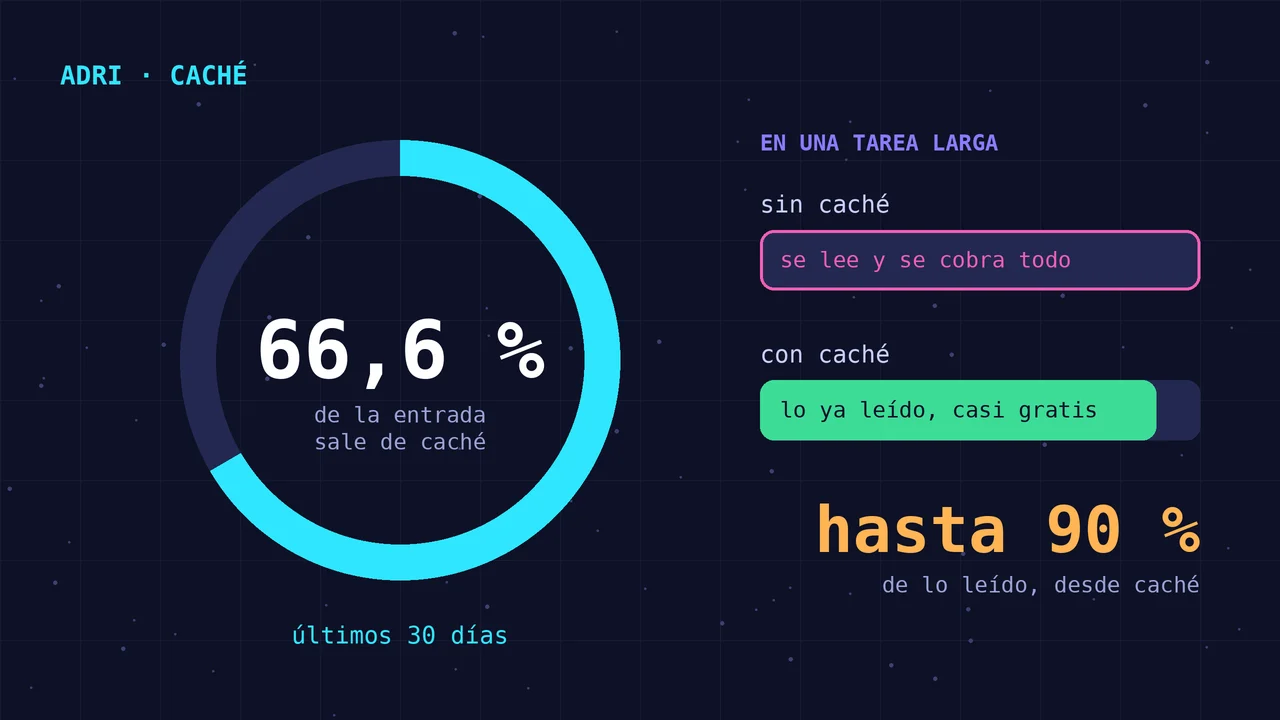
- Negli ultimi 30 giorni, il 66,6 % di circa 1.000 milioni di token di input è arrivato dalla cache, distribuito su 10.299 attività. Il risparmio misurato è di circa 344 €.
E per attività, la distribuzione è questa:
| Quali attività | Parte che esce dalla cache |
|---|---|
| Almeno la metà delle attività | 76 % |
| Il 10 % migliore | 87 % |
| Attività lunghe | fino al 90 % |
Il 5 % delle attività supera il 90 %, e il massimo che abbiamo osservato è il 92,5 %. Le attività lunghe sono quelle che ne traggono maggior vantaggio, perché sono quelle che rileggono di più.
Una precisazione importante: il 90 % non è uno sconto del 90 % sulla tua fattura. È la parte di ciò che l'IA legge che esce dalla cache nelle attività lunghe. Quella parte viene addebitata a un prezzo molto più basso, ma il resto del costo dell'attività, come ciò che l'IA scrive, resta quello che è.
Come lo otteniamo
Il fornitore riconosce solo l'inizio del testo. Se qualcosa cambia all'inizio, non coincide più e addebita di nuovo tutto. Per questo l'importante è l'ordine.
Quello che facciamo è ordinare ciò che l'IA legge in questo modo:
- Prima, ciò che è stabile: le istruzioni, gli strumenti e il contesto dell'azienda, sempre nello stesso ordine.
- Alla fine, ciò che cambia: la nuova richiesta e i risultati più recenti.
Così, da un passaggio al successivo, l'inizio resta identico e il fornitore lo riconosce. Solo la parte finale viene riprocessata. È un lavoro di ordine e disciplina più che di magia, e si nota ogni giorno.
Cosa ci guadagni
- Meno costo per attività. È una delle ragioni per cui l'IA può essere inclusa nei piani per utente, con quota fissa.
- Risposte che iniziano prima. Quello che è già stato letto non va riprocessato.
- Lo stesso risultato. La cache non cambia ciò che l'IA risponde: cambia quanto costa leggere.
Un esempio per farti un'idea
Immagina di chiedere ad ADRI di controllare le fatture in sospeso di un cliente e prepararti un'email di sollecito. Per farlo consulta l'ERP, legge lo storico del cliente, verifica le date e redige il testo. Sono diversi passaggi consecutivi.
In ogni passaggio, le istruzioni di ADRI, i suoi strumenti e il contesto della tua azienda sono gli stessi. Con la cache, quella parte viene letta una volta e riutilizzata nei passaggi successivi. Senza di essa, verrebbe letta e addebitata di nuovo ogni volta. Più passaggi ha l'attività, più si nota la differenza, ed è per questo che le attività lunghe sono quelle che più si avvicinano al 90 %.
In sintesi
ADRI svolge lavoro, e lavorare implica rileggere. Grazie alla cache, negli ultimi 30 giorni il 66,6 % di ciò che ha letto è arrivato dalla memoria invece di essere riprocessato, e nelle attività lunghe la proporzione arriva fino al 90 %. Per te significa attività più economiche e più rapide, con la stessa qualità.
Se vuoi capire come si distribuisce il lavoro tra gli specialisti, leggi come funziona il sistema di agenti di ADRI. E se hai dubbi su cifre o piani, scrivici a [email protected].
- Cache
- Token
- Costo dell'IA
- ADRI