
Se pedires à ADRI que prepare um orçamento, reveja o teu correio ou atualize um cliente no CRM, não faz uma única leitura. Trabalha por passos: lê, usa uma ferramenta, lê o resultado e volta a pensar. E, em cada passo, a IA volta a ler o que veio antes. Esse texto repetido é caro, e a cache existe para que não o pagues inteiro todas as vezes.
Os números deste artigo são medições próprias da BionicAdri, recolhidas na nossa plataforma desde que começámos a medir a cache, em finais de agosto de 2026.
O que a ADRI lê em cada passo
Quando a ADRI começa uma tarefa, a IA recebe sempre um pacote de texto. Dentro vão as suas instruções, as ferramentas que pode usar, o contexto da tua empresa, o histórico do que já fez e, no final, o teu pedido concreto.
De um passo para o seguinte, quase todo esse pacote é idêntico. Muda pouco: o último resultado de uma ferramenta ou a frase seguinte da conversa. Reler o mesmo do zero todas as vezes seria como pedir a um funcionário que, antes de cada chamada, voltasse a ler o manual da empresa inteiro.
O que é a cache, com uma imagem simples
A cache é uma memória de curto prazo do fornecedor da IA. Se o início do texto for igual ao de há uns instantes, o fornecedor reconhece-o, não o volta a processar e cobra-o muito mais barato. Só volta a trabalhar com o que é novo.
Pensa num arquivador com a pasta do teu cliente já aberta em cima da mesa. Não a tiras, não a folheias outra vez: tens-la à mão e só acrescentas a folha nova.
Quanto mais barato fica
Na tarifa pública da BionicAdri, um milhão de tokens de entrada custa 0,585 € e um milhão servido a partir da cache custa 0,06 €. É quase 10 vezes menos. Se não sabes o que é um token, está explicado na secção Postos e tokens da página de preços, com entrada, saída e cache.
| Como se lê | Preço por milhão de tokens |
|---|---|
| Entrada normal | 0,585 € |
| Servido a partir da cache | 0,06 € |
Quanta cache é realmente aproveitada
Não basta que a cache exista: é preciso conseguir que seja usada. Isto foi o que medimos:
- Semana a semana, desde setembro de 2026, entre 63 % e 71 % de todos os tokens de entrada são servidos a partir da cache.
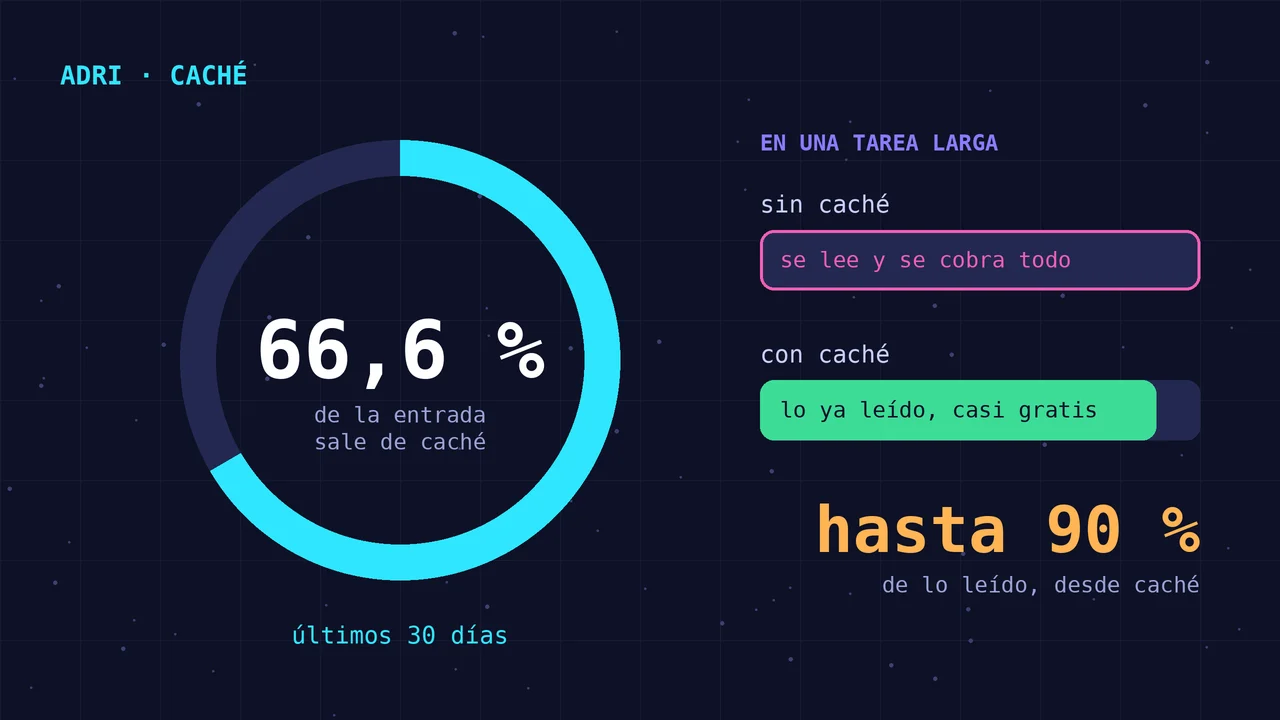
- Nos últimos 30 dias, os 66,6 % de cerca de mil milhões de tokens de entrada saíram da cache, distribuídos por 10.299 tarefas. A poupança medida é de cerca de 344 €.
E por tarefa, a distribuição é esta:
| Que tarefas | Parte que sai da cache |
|---|---|
| Metade das tarefas, pelo menos | 76 % |
| Os 10 % melhores | 87 % |
| Tarefas longas | até 90 % |
5 % das tarefas supera os 90 %, e o máximo que observámos é 92,5 %. As tarefas longas são as que mais ganham, porque são as que mais releem.
Um esclarecimento importante: os 90 % não são um desconto de 90 % na tua fatura. É a parte do que a IA lê que sai da cache nas tarefas longas. Essa parte é cobrada muito mais barata, mas o resto do custo da tarefa, como o que a IA escreve, continua a ser o que é.
Como o conseguimos
O fornecedor só reconhece o início do texto. Se algo muda no começo, já não coincide e volta a cobrar tudo. Por isso, o importante é a ordem.
O que fazemos é ordenar o que a IA lê da seguinte forma:
- Primeiro, o que é estável: as instruções, as ferramentas e o contexto da empresa, sempre na mesma ordem.
- No final, o que muda: o novo pedido e os resultados mais recentes.
Assim, de um passo para o seguinte, o início fica idêntico e o fornecedor reconhece-o. Só se processa de novo a parte final. É um trabalho de ordem e disciplina mais do que de magia, e nota-se diariamente.
O que ganhas tu
- Menos custo por tarefa. É uma das razões pelas quais a IA pode ser incluída nos planos por posto, com quota fixa.
- Respostas que começam mais cedo. O que já está lido não precisa de ser processado outra vez.
- O mesmo resultado. A cache não muda o que a IA responde: muda o que custa ler.
Um exemplo para teres uma ideia
Imagina que pedes à ADRI para rever as faturas pendentes de um cliente e te preparar um e-mail de reclamação. Para o fazer, consulta o ERP, lê o histórico do cliente, verifica as datas e redige o texto. São vários passos seguidos.
Em cada passo, as instruções da ADRI, as suas ferramentas e o contexto da tua empresa são os mesmos. Com a cache, essa parte é lida uma vez e reutilizada nos passos seguintes. Sem ela, seria lida e cobrada de novo a cada vez. Quanto mais passos tem a tarefa, mais se nota a diferença, e é por isso que as tarefas longas são as que mais se aproximam dos 90 %.
Em resumo
A ADRI faz trabalho, e trabalhar implica reler. Graças à cache, nos últimos 30 dias, 66,6 % do que leu saiu da memória em vez de voltar a ser processado, e nas tarefas longas a proporção chega até 90 %. Para ti significa tarefas mais baratas e mais rápidas, com a mesma qualidade.
Se quiseres perceber como se distribui o trabalho entre especialistas, lê como funciona o sistema de agentes da ADRI. E se tiveres dúvidas sobre números ou planos, escreve-nos para [email protected].
- Cache
- Tokens
- Custo da IA
- ADRI