
Si le pides a ADRI que prepare un presupuesto, revise tu correo o ponga al día un cliente en el CRM, no hace una sola lectura. Trabaja por pasos: lee, usa una herramienta, lee el resultado y vuelve a pensar. Y en cada paso la IA vuelve a leer lo anterior. Ese texto repetido es caro, y la caché existe para que no lo pagues entero cada vez.
Los números de este artículo son mediciones propias de BionicAdri, tomadas en nuestra plataforma desde que empezamos a medir la caché, a finales de agosto de 2026.
Qué lee ADRI en cada paso
Cuando ADRI se pone con una tarea, la IA recibe siempre un paquete de texto. Dentro van sus instrucciones, las herramientas que puede usar, el contexto de tu empresa, el historial de lo que lleva hecho y, al final, tu petición concreta.
De un paso al siguiente, casi todo ese paquete es idéntico. Cambia poco: el último resultado de una herramienta o la siguiente frase de la conversación. Releer lo mismo desde cero cada vez sería como pedirle a un empleado que, antes de cada llamada, volviera a leerse el manual de la empresa entero.
Qué es la caché, con una imagen sencilla
La caché es una memoria a corto plazo del proveedor de la IA. Si el principio del texto es igual que el de hace unos instantes, el proveedor lo reconoce, no lo vuelve a procesar y lo cobra mucho más barato. Solo trabaja de nuevo con lo que es nuevo.
Piensa en un archivador con la carpeta de tu cliente ya abierta sobre la mesa. No la sacas, no la hojeas otra vez: la tienes a mano y solo añades la hoja nueva.
Cuánto más barato sale
En la tarifa pública de BionicAdri, un millón de tokens de entrada cuesta 0,585 € y un millón servido desde caché cuesta 0,06 €. Es casi 10 veces menos. Si no sabes qué es un token, está explicado en la sección Asientos y tokens de la página de precios, con entrada, salida y caché.
| Cómo se lee | Precio por millón de tokens |
|---|---|
| Entrada normal | 0,585 € |
| Servido desde caché | 0,06 € |
Cuánta caché se aprovecha de verdad
Que la caché exista no basta: hay que conseguir que se use. Esto es lo que hemos medido:
- Semana a semana, desde septiembre de 2026, entre el 63 % y el 71 % de todos los tokens de entrada se sirven desde caché.
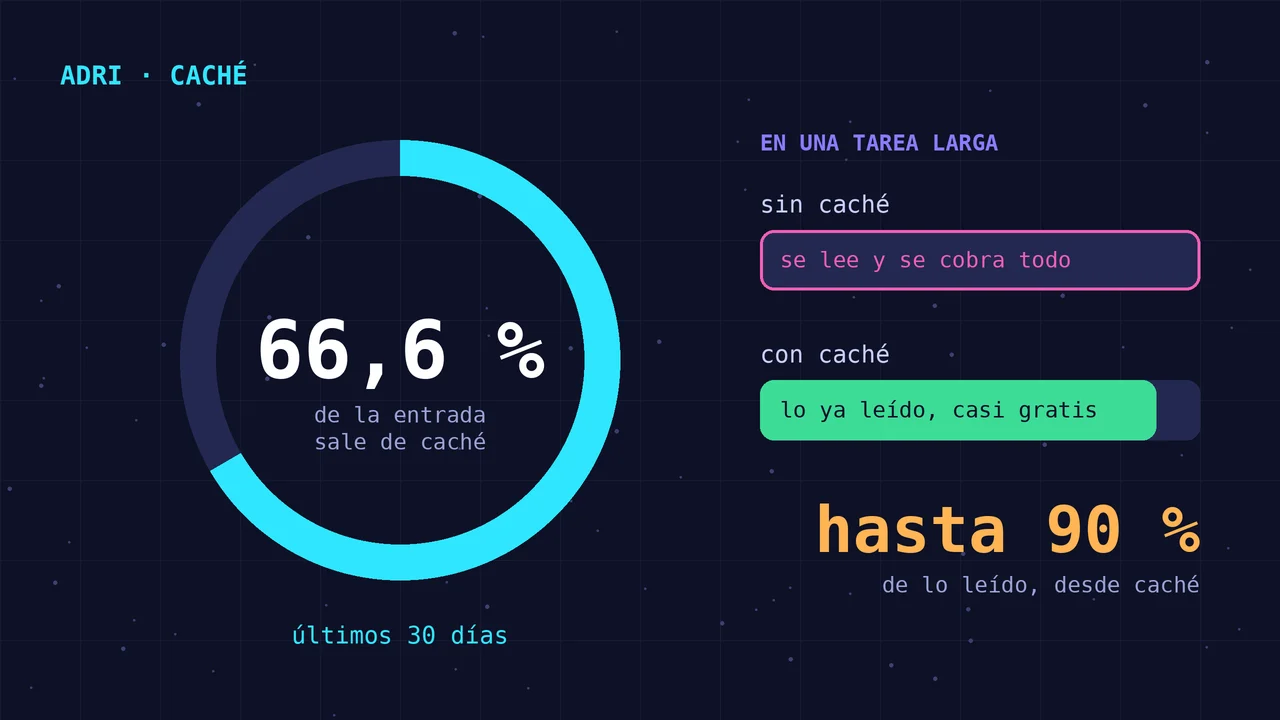
- En los últimos 30 días, el 66,6 % de unos 1.000 millones de tokens de entrada salieron de caché, repartidos en 10.299 tareas. El ahorro medido es de unos 344 €.
Y por tarea, el reparto es este:
| Qué tareas | Parte que sale de caché |
|---|---|
| La mitad de las tareas, al menos | 76 % |
| El 10 % mejor | 87 % |
| Tareas largas | hasta 90 % |
El 5 % de las tareas supera el 90 %, y el máximo que hemos observado es el 92,5 %. Las tareas largas son las que más ganan, porque son las que más releen.
Una aclaración importante: el 90 % no es un descuento del 90 % en tu factura. Es la parte de lo que la IA lee que sale de caché en las tareas largas. Esa parte se cobra mucho más barata, pero el resto del coste de la tarea, como lo que la IA escribe, sigue siendo el que es.
Cómo lo conseguimos
El proveedor solo reconoce el principio del texto. Si algo cambia al comienzo, ya no coincide y vuelve a cobrar todo. Por eso lo importante es el orden.
Lo que hacemos es ordenar lo que lee la IA así:
- Primero, lo estable: las instrucciones, las herramientas y el contexto de la empresa, siempre en el mismo orden.
- Al final, lo que cambia: la petición nueva y los resultados más recientes.
Así, de un paso al siguiente, el principio queda idéntico y el proveedor lo reconoce. Solo se procesa de nuevo la parte final. Es un trabajo de orden y disciplina más que de magia, y se nota a diario.
Qué ganas tú
- Menos coste por tarea. Es una de las razones por las que la IA puede ir incluida en los planes por asiento, con cuota fija.
- Respuestas que empiezan antes. Lo que ya está leído no hay que procesarlo otra vez.
- El mismo resultado. La caché no cambia lo que responde la IA: cambia lo que cuesta leer.
Un ejemplo para hacerte una idea
Imagina que le pides a ADRI que revise las facturas pendientes de un cliente y te prepare un correo de reclamación. Para hacerlo consulta el ERP, lee el historial del cliente, comprueba las fechas y redacta el texto. Son varios pasos seguidos.
En cada paso, las instrucciones de ADRI, sus herramientas y el contexto de tu empresa son los mismos. Con la caché, esa parte se lee una vez y se reutiliza en los pasos siguientes. Sin ella, se leería y se cobraría de nuevo cada vez. Cuantos más pasos tiene la tarea, más se nota la diferencia, y por eso las tareas largas son las que más se acercan al 90 %.
En resumen
ADRI hace trabajo, y trabajar implica releer. Gracias a la caché, en los últimos 30 días el 66,6 % de lo que leyó salió de memoria en lugar de volver a procesarse, y en las tareas largas la proporción llega hasta el 90 %. Para ti significa tareas más baratas y más rápidas, con la misma calidad.
Si quieres entender cómo se reparte el trabajo entre especialistas, lee cómo funciona el sistema de agentes de ADRI. Y si tienes dudas sobre cifras o planes, escríbenos a [email protected].
- Caché
- Tokens
- Coste de la IA
- ADRI