
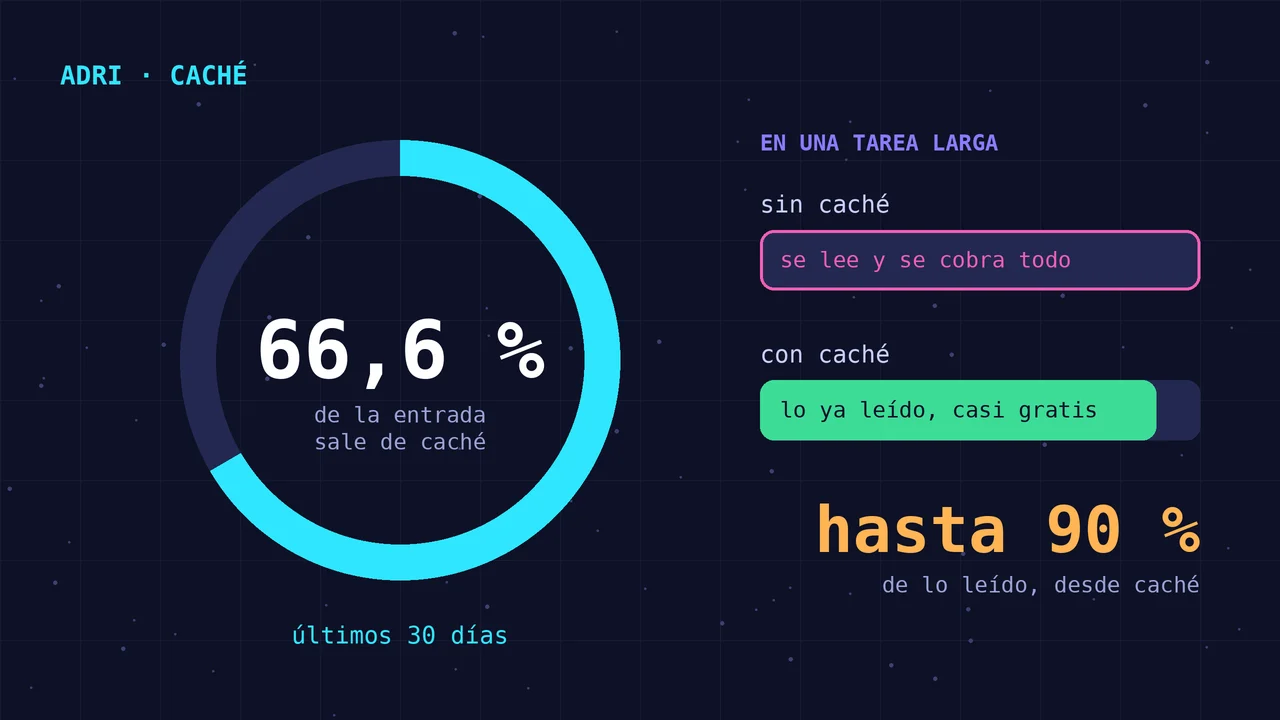
Dacă îi ceri lui ADRI să pregătească un buget, să-ți verifice e-mailul sau să actualizeze un client în CRM, nu face o singură citire. Lucrează pe pași: citește, folosește un instrument, citește rezultatul și se gândește din nou. Și la fiecare pas IA recitește ceea ce a fost înainte. Acel text repetat este scump, iar cache-ul există pentru ca tu să nu îl plătești întreg de fiecare dată.
Numerele din acest articol sunt măsurători proprii ale BionicAdri, realizate pe platforma noastră de când am început să măsurăm cache-ul, la sfârșitul lunii august 2026.
Ce citește ADRI la fiecare pas
Când ADRI se apucă de o sarcină, IA primește întotdeauna un pachet de text. Înăuntru se află instrucțiunile sale, instrumentele pe care le poate folosi, contextul companiei tale, istoricul a ceea ce a făcut până acum și, la final, cererea ta concretă.
De la un pas la următorul, aproape tot acel pachet este identic. Se schimbă puțin: ultimul rezultat al unui instrument sau următoarea frază a conversației. Să recitești același lucru de la zero de fiecare dată ar fi ca și cum i-ai cere unui angajat ca, înainte de fiecare apel, să recitească manualul companiei în întregime.
Ce este cache-ul, cu o imagine simplă
Cache-ul este o memorie pe termen scurt a furnizorului de IA. Dacă începutul textului este identic cu cel de acum câteva clipe, furnizorul îl recunoaște, nu îl mai procesează din nou și îl taxează mult mai ieftin. Lucrează din nou doar cu ceea ce este nou.
Gândește-te la un dulap de arhivă cu dosarul clientului tău deja deschis pe masă. Nu îl scoți, nu îl răsfoiești din nou: îl ai la îndemână și doar adaugi foaia nouă.
Cât de mult mai ieftin iese
În tariful public BionicAdri, un milion de tokenuri de intrare costă 0,585 €, iar un milion servit din cache costă 0,06 €. Este de aproape 10 ori mai puțin. Dacă nu știi ce este un token, este explicat în secțiunea Locuri și tokenuri de pe pagina de prețuri, cu intrare, ieșire și cache.
| Cum se citește | Preț pe milion de tokenuri |
|---|---|
| Intrare normală | 0,585 € |
| Servit din cache | 0,06 € |
Cât cache se folosește cu adevărat
Faptul că cache-ul există nu este suficient: trebuie să reușim să fie folosit. Iată ce am măsurat:
- Săptămână după săptămână, din septembrie 2026, între 63 % și 71 % din toți tokenii de intrare sunt serviți din cache.
- În ultimele 30 de zile, 66,6 % din aproximativ 1.000 de milioane de tokeni de intrare au ieșit din cache, repartizați în 10.299 de sarcini. Economia măsurată este de aproximativ 344 €.
Iar pe sarcină, distribuția este aceasta:
| Ce sarcini | Partea care iese din cache |
|---|---|
| Jumătate dintre sarcini, cel puțin | 76 % |
| Top 10 % | 87 % |
| Sarcini lungi | până la 90 % |
5 % dintre sarcini depășesc 90 %, iar maximul pe care l-am observat este 92,5 %. Sarcinile lungi sunt cele care câștigă cel mai mult, pentru că sunt cele care recitesc cel mai mult.
O clarificare importantă: 90 % nu este o reducere de 90 % pe factura ta. Este partea din ceea ce citește IA care iese din cache în sarcinile lungi. Acea parte se taxează mult mai ieftin, dar restul costului sarcinii, cum ar fi ce scrie IA, rămâne cel care este.
Cum reușim asta
Furnizorul recunoaște doar începutul textului. Dacă ceva se schimbă la început, nu mai coincide și taxează din nou tot. De aceea contează ordinea.
Ceea ce facem este să ordonăm ce citește IA astfel:
- Mai întâi, partea stabilă: instrucțiunile, instrumentele și contextul companiei, mereu în aceeași ordine.
- La final, ceea ce se schimbă: cererea nouă și rezultatele cele mai recente.
Astfel, dintr-un pas în următorul, începutul rămâne identic și furnizorul îl recunoaște. Doar partea finală este procesată din nou. Este o muncă de ordine și disciplină, mai degrabă decât de magie, și se simte zi de zi.
Ce câștigi tu
- Cost mai mic pe sarcină. Este unul dintre motivele pentru care IA poate fi inclusă în planurile pe loc, cu taxă fixă.
- Răspunsuri care încep mai repede. Ceea ce este deja citit nu mai trebuie procesat încă o dată.
- Același rezultat. Cache-ul nu schimbă ce răspunde IA: schimbă cât costă cititul.
Un exemplu ca să-ți faci o idee
Imaginează-ți că îi ceri ADRI să verifice facturile restante ale unui client și să-ți pregătească un e-mail de reclamație. Pentru asta consultă ERP-ul, citește istoricul clientului, verifică datele și redactează textul. Sunt mai mulți pași consecutivi.
La fiecare pas, instrucțiunile ADRI, instrumentele sale și contextul companiei tale sunt aceleași. Cu cache-ul, acea parte se citește o dată și se reutilizează în pașii următori. Fără el, s-ar citi și s-ar factura din nou de fiecare dată. Cu cât sarcina are mai mulți pași, cu atât diferența se simte mai mult, și de aceea sarcinile lungi sunt cele care se apropie cel mai mult de 90 %.
Pe scurt
ADRI face treabă, iar a lucra implică recitire. Datorită cache-ului, în ultimele 30 de zile, 66,6 % din ce a citit a venit din memorie în loc să fie procesat din nou, iar în sarcinile lungi proporția ajunge până la 90 %. Pentru tine înseamnă sarcini mai ieftine și mai rapide, cu aceeași calitate.
Dacă vrei să înțelegi cum se împarte munca între specialiști, citește cum funcționează sistemul de agenți al ADRI. Iar dacă ai întrebări despre cifre sau planuri, scrie-ne la [email protected].
- Cache
- Tokeni
- Costul IA
- ADRI