
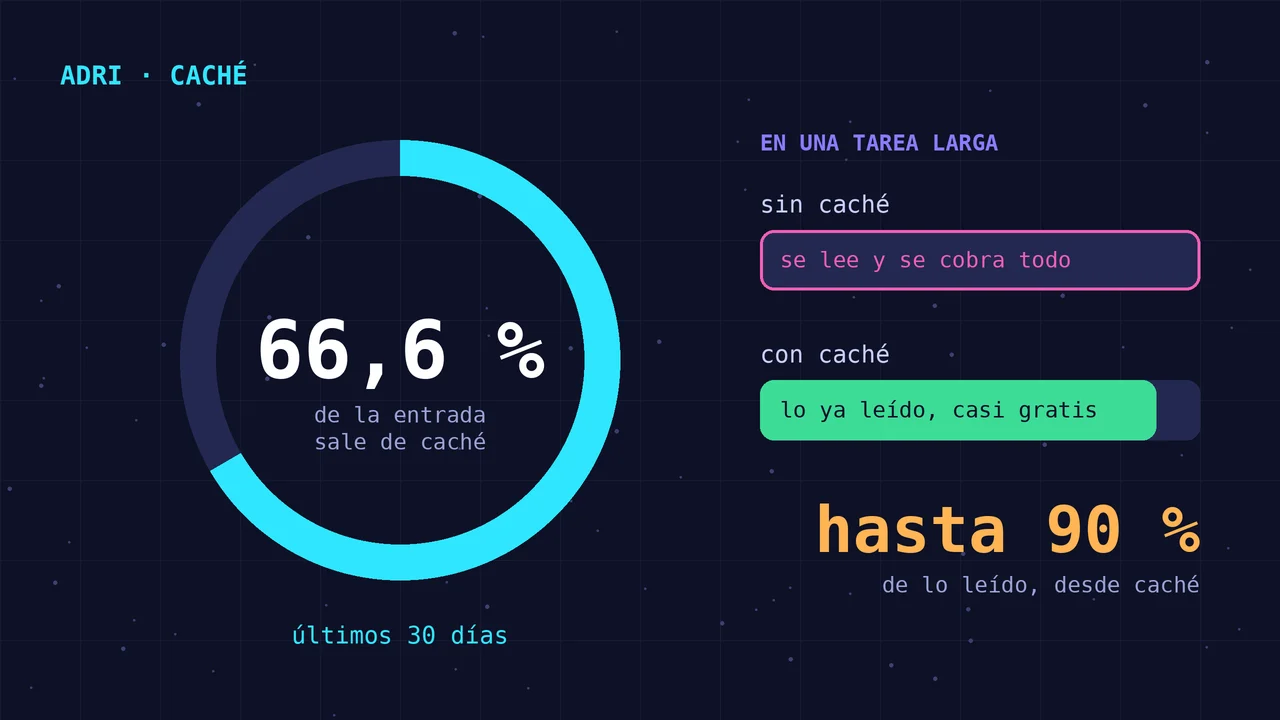
Si tu demandes à ADRI de préparer un devis, de vérifier tes e-mails ou de mettre à jour un client dans le CRM, elle ne fait pas une seule lecture. Elle travaille par étapes : elle lit, utilise un outil, lit le résultat et réfléchit à nouveau. Et à chaque étape, l'IA relit ce qui précède. Ce texte répété est cher, et le cache existe pour que tu ne le paies pas entier à chaque fois.
Les chiffres de cet article sont des mesures propres à BionicAdri, prises sur notre plateforme depuis que nous avons commencé à mesurer le cache, fin août 2026.
Ce qu'ADRI lit à chaque étape
Quand ADRI se met à une tâche, l'IA reçoit toujours un paquet de texte. À l'intérieur se trouvent ses instructions, les outils qu'elle peut utiliser, le contexte de ton entreprise, l'historique de ce qu'elle a fait et, à la fin, ta demande concrète.
D'une étape à l'autre, presque tout ce paquet est identique. Peu de choses changent : le dernier résultat d'un outil ou la phrase suivante de la conversation. Relire la même chose depuis zéro à chaque fois reviendrait à demander à un employé, avant chaque appel, de relire tout le manuel de l'entreprise.
Qu'est-ce que le cache, avec une image simple
Le cache est une mémoire à court terme du fournisseur de l'IA. Si le début du texte est identique à celui d'il y a quelques instants, le fournisseur le reconnaît, ne le retraite pas et le facture beaucoup moins cher. Il ne retravaille que ce qui est nouveau.
Pense à un classeur avec le dossier de ton client déjà ouvert sur la table. Tu ne le sors pas, tu ne le feuillettes pas à nouveau : tu l'as sous la main et tu n'ajoutes que la nouvelle feuille.
Combien c'est moins cher
Dans la tarification publique de BionicAdri, un million de tokens d'entrée coûte 0,585 € et un million servi depuis le cache coûte 0,06 €. C'est presque 10 fois moins. Si tu ne sais pas ce qu'est un token, c'est expliqué dans la section Sièges et tokens de la page des prix, avec entrée, sortie et cache.
| Comment le lire | Prix par million de tokens |
|---|---|
| Entrée normale | 0,585 € |
| Servi depuis le cache | 0,06 € |
Quelle part de cache est réellement exploitée
Que le cache existe ne suffit pas : il faut réussir à ce qu'il soit utilisé. Voici ce que nous avons mesuré :
- D'une semaine à l'autre, depuis septembre 2026, entre 63 % et 71 % de tous les tokens d'entrée sont servis depuis le cache.
- Ces 30 derniers jours, 66,6 % d'environ 1 000 millions de tokens d'entrée sont sortis du cache, répartis sur 10 299 tâches. L'économie mesurée est d'environ 344 €.
Et par tâche, la répartition est la suivante :
| Quelles tâches | Part qui provient du cache |
|---|---|
| La moitié des tâches, au moins | 76 % |
| Les 10 % les meilleures | 87 % |
| Tâches longues | jusqu'à 90 % |
5 % des tâches dépassent 90 %, et le maximum que nous avons observé est de 92,5 %. Les tâches longues sont celles qui y gagnent le plus, parce que ce sont celles qui relisent le plus.
Une précision importante : les 90 % ne sont pas une remise de 90 % sur votre facture. C'est la part de ce que l'IA lit qui provient du cache dans les tâches longues. Cette part est facturée beaucoup moins cher, mais le reste du coût de la tâche, comme ce que l'IA écrit, reste ce qu'il est.
Comment nous y parvenons
Le fournisseur ne reconnaît que le début du texte. Si quelque chose change au commencement, cela ne correspond plus et il facture à nouveau tout. C'est pourquoi l'ordre est important.
Ce que nous faisons, c'est organiser ce que lit l'IA ainsi :
- D'abord, ce qui est stable : les instructions, les outils et le contexte de l'entreprise, toujours dans le même ordre.
- À la fin, ce qui change : la nouvelle requête et les résultats les plus récents.
Ainsi, d'une étape à l'autre, le début reste identique et le fournisseur le reconnaît. Seule la partie finale est retraitée. C'est un travail d'ordre et de discipline plus que de magie, et cela se remarque au quotidien.
Ce que vous y gagnez
- Moins de coût par tâche. C'est l'une des raisons pour lesquelles l'IA peut être incluse dans les offres par utilisateur, avec un forfait fixe.
- Des réponses qui commencent plus tôt. Ce qui est déjà lu n'a pas besoin d'être traité à nouveau.
- Le même résultat. Le cache ne change pas ce que répond l'IA : il change ce que coûte la lecture.
Un exemple pour vous faire une idée
Imaginez que vous demandez à ADRI de vérifier les factures en attente d'un client et de vous préparer un e-mail de réclamation. Pour ce faire, il consulte l'ERP, lit l'historique du client, vérifie les dates et rédige le texte. Cela fait plusieurs étapes à la suite.
À chaque étape, les instructions d'ADRI, ses outils et le contexte de votre entreprise sont les mêmes. Avec le cache, cette partie est lue une fois et réutilisée dans les étapes suivantes. Sans lui, elle serait relue et facturée à nouveau à chaque fois. Plus une tâche comporte d'étapes, plus la différence se fait sentir, et c'est pourquoi les tâches longues sont celles qui s'approchent le plus des 90 %.
En résumé
ADRI fait le travail, et travailler implique de relire. Grâce au cache, ces 30 derniers jours, 66,6 % de ce qu'il a lu a été servi depuis le cache au lieu d'être retraité, et sur les tâches longues, la proportion atteint jusqu'à 90 %. Pour vous, cela signifie des tâches moins coûteuses et plus rapides, avec la même qualité.
Si vous souhaitez comprendre comment le travail se répartit entre les spécialistes, lisez comment fonctionne le système d'agents d'ADRI. Et si vous avez des questions sur les chiffres ou les offres, écrivez-nous à [email protected].
- Cache
- Tokens
- Coût de l'IA
- ADRI