
Qu'est-ce qu'un « harnais » et pourquoi c'est important
Quand tu embauches une personne très intelligente, tu ne lui donnes pas seulement un ordinateur. Tu lui donnes un poste, un chef, des règles, un budget et quelqu'un qui vérifie l'important. Avec l'intelligence artificielle, c'est la même chose.
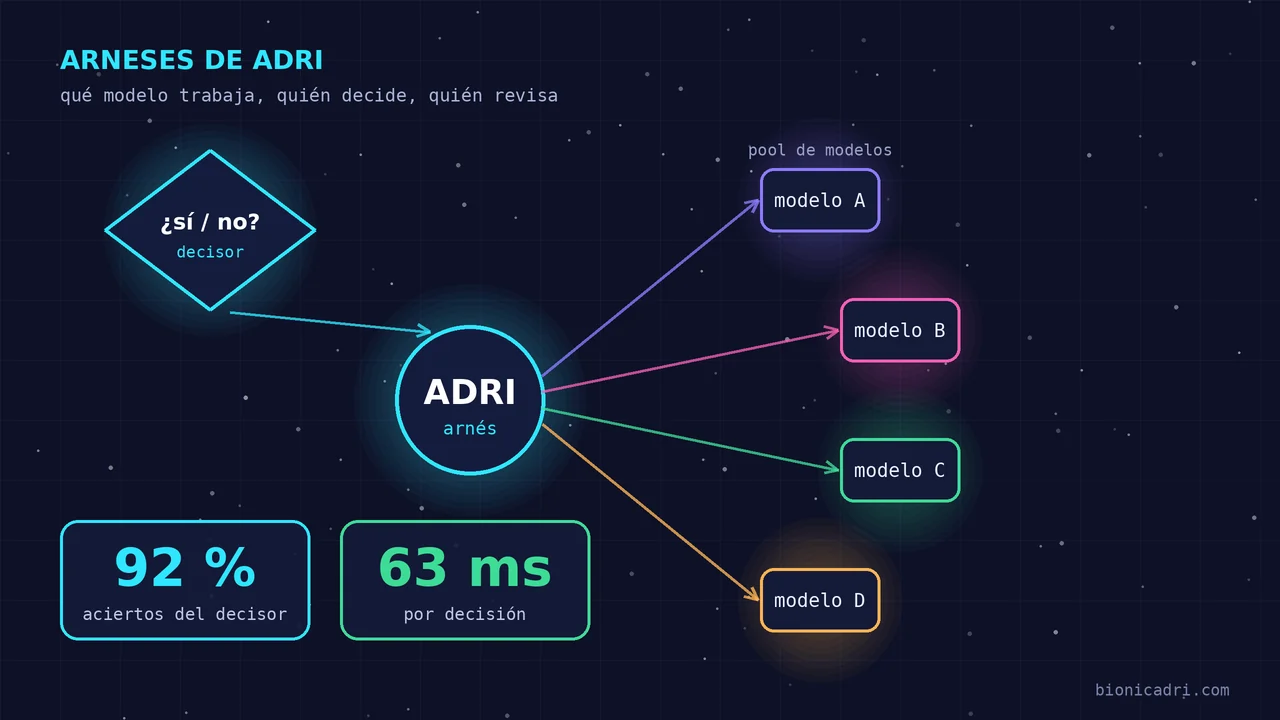
Le harnais est tout ce qui entoure le modèle d'IA : quel modèle utilise chaque spécialiste, comment les requêtes sont réparties, ce qui est retenté, ce qui est décidé et quand on s'arrête. Le modèle apporte l'intelligence ; le harnais apporte le critère et la sécurité.
ADRI, l'équipe de spécialistes de BionicAdri, fonctionne ainsi. Ici, nous t'expliquons comment, sans jargon technique.
Qui travaille à chaque tâche : le chef d'équipe
Chaque spécialiste d'ADRI demande du travail à un groupe de modèles, que nous appelons « pool », via un gateway propre. Pense au gateway comme à un chef d'équipe qui répartit les tâches entre les employés disponibles.
Depuis le 19 septembre, ADRI ne choisit plus le modèle à la main. C'est le gateway qui le fait, avec trois règles simples :
- Par priorité. On appelle d'abord les modèles préférés.
- À priorité égale, le moins occupé. Comme à une caisse de supermarché : on te place là où il y a le moins de queue.
- Saute les modèles saturés ou tombés avant de commencer à répondre, pour que personne n'attende un modèle qui ne va pas répondre.
De plus, la facture ne va qu'au modèle qui a répondu. Si l'un était tombé et qu'il a été sauté, cela ne coûte rien.
Comme modèle principal, nous utilisons Qwen, open source.
Moins de niveaux, plus de clarté
Avant, il y avait trois niveaux de qualité : bas, normal et élevé. Le 7 septembre, nous les avons retirés parce qu'en mesurant, deux d'entre eux allaient vers le même modèle : c'était de la complexité sans bénéfice. Aujourd'hui, il y a un groupe par spécialiste. La voix en direct a le sien, et là, ce qui compte, c'est la rapidité de réponse.
Que se passe-t-il si un modèle échoue
Les modèles se trompent parfois de manières très concrètes : la réponse est coupée au milieu d'une phrase, ou le modèle se met à répéter la même chose en boucle.
Dans ce cas, ADRI n'abandonne pas et ne te livre pas une demi-réponse. Il demande le travail à un autre modèle du groupe, comme un chef qui, si un employé se retrouve bloqué, passe la tâche à un collègue. Il y a une limite : au maximum deux sauts par requête, pour qu'un problème ne se transforme pas en une chaîne interminable.
Les petites décisions : l'arbitre
Un système avec de nombreux spécialistes prend des centaines de petites décisions : à qui va cette requête ? quelle méthode utiliser pour chercher ces données ? Avant, elles étaient résolues avec des règles rigides de mots-clés : « si le message contient tel mot, il va à tel endroit ». Elles fonctionnent jusqu'à ce que quelqu'un s'exprime autrement.
Pour cela, ADRI a un décideur, un petit modèle (environ 9 milliards de paramètres) qui n'écrit pas de textes. C'est comme un arbitre : il ne répond qu'à des questions par oui ou non, ou choisit entre des options, et dit avec quelle probabilité il le pense. Il remplace les règles de mots-clés dans environ 36 décisions du système.
Comment il a été introduit, étape par étape
- En mode ombre. Le décideur note seulement ce qu'il aurait décidé et si cela coïncide avec l'ancienne règle. Il n'envoie rien.
- Jours de trafic réel. On le laisse observer du vrai travail avant de lui donner du pouvoir.
- Décision par décision. S'active une par une, pas toutes d'un coup.
En sécurité, de plus, il a les mains liées : il ne peut que durcir, jamais donner une autorisation. En cas de doute, son veto ne peut que retirer un « oui », jamais l'ajouter.
Ce que nous mesurons
Sur une base de 526 cas réels :
| Décideur | Taux de réussite |
|---|---|
| Le précédent | 89 % |
| L'actuel | 92-93 % |
Et il le fait rapidement : environ 63 millisecondes par décision, en moyenne. En cas de doute (confiance faible), il peut consulter un modèle plus grand. Mais nous avons aussi mesuré cela : avec des juges aveugles, le 9 octobre, nous avons cessé d'escalader le texte, parce que le petit modèle avait plus souvent raison (10 contre 6 dans les cas où ils différaient). Parfois, le grand n'améliore pas le petit.
Un exemple réel
Le 9 octobre, nous avons modifié quelque chose dans le superviseur : il n'envoie plus « en programmation » ce dont il ne sait pas où cela s'insère. En 14 jours, nous avons vu que 22 des 73 demandes adressées à la programmation étaient simplement « lis ce fichier ». Désormais, c'est la personne compétente qui le résout, et la programmation se consacre à programmer.
Sans plafonds fixes : un contrôle de progression
Le 4 octobre, nous avons supprimé les plafonds fixes de travail. Avant, une tâche était coupée après X appels, qu'elle ait du sens ou non. C'était comme dire à un employé : « à 15 heures, tu arrêtes ce que tu es en train de faire ».
Désormais, un contrôle de progression évalue s'il vaut la peine de continuer, de changer d'approche ou de s'arrêter et de livrer ce qui a été rassemblé. Un plafond de dépenses par tâche est maintenu dans la passerelle comme fusible : si quelque chose s'emballait, le coût a une limite.
Comment plusieurs modèles révisent le travail
Pour le code, la sécurité et les parties délicates, ADRI peut lancer plusieurs modèles de familles différentes en parallèle, chacun avec son propre focus, et rassembler ce qu'ils trouvent. C'est comme demander l'avis à plusieurs relecteurs indépendants qui ne se sont pas concertés au préalable.
Pourquoi des familles différentes ? Parce que chacune se trompe différemment. Ce qui échappe à l'une, une autre le voit.
Une seule opinion ne suffit pas ; la convergence, oui
Lors d'une mesure interne sur 1 112 constats :
- Une alerte isolée d'un seul modèle est correcte dans 16-25 % des cas.
- Lorsque 3 ou 4 familles convergent, le taux de réussite est d'environ 90 %.
C'est pourquoi ce qui compte, c'est la convergence, pas l'alerte d'un seul. Et l'important est toujours vérifié par une personne.
Une leçon de juilletUn benchmark du 11 juillet nous a appris quelque chose d'utile : réunir quatre modèles « relève le plancher » (filtre les erreurs) mais pas « le plafond » (ne les rend pas plus intelligents). Cela sert à se tromper moins, pas à être un génie.
Ce que cela signifie pour votre entreprise
- Moins de frayeurs. Si un modèle échoue, un autre poursuit le travail.
- Décisions mesurées. Chaque changement a été testé avant d'être activé, avec des chiffres.
- Sécurité par conception. Dans les cas délicats, le système ne peut que fermer des portes.
- Contrôle des dépenses. Un plafond par tâche évite les coûts imprévus.
- Une personne au final. L'IA propose et filtre ; l'important est validé par quelqu'un.
Conclusion
L'intelligence d'un assistant ne réside pas seulement dans le modèle. Elle réside dans la manière dont le travail est réparti, dont les pannes sont gérées, qui tranche les doutes et qui vérifie. C'est la partie que nous construisons chez BionicAdri.
Si vous voulez voir ADRI travailler avec les données de votre entreprise, demandez une démo ou écrivez-nous à [email protected].
- Agents IA
- Passerelle de modèles
- Décideur
- Révision multimodèle
Si vous voulez voir comment fonctionnent en interne les modèles qui surveillent chaque étape, lisez modèles de décision miroir : comment ADRI décide, surveille et se corrige.