
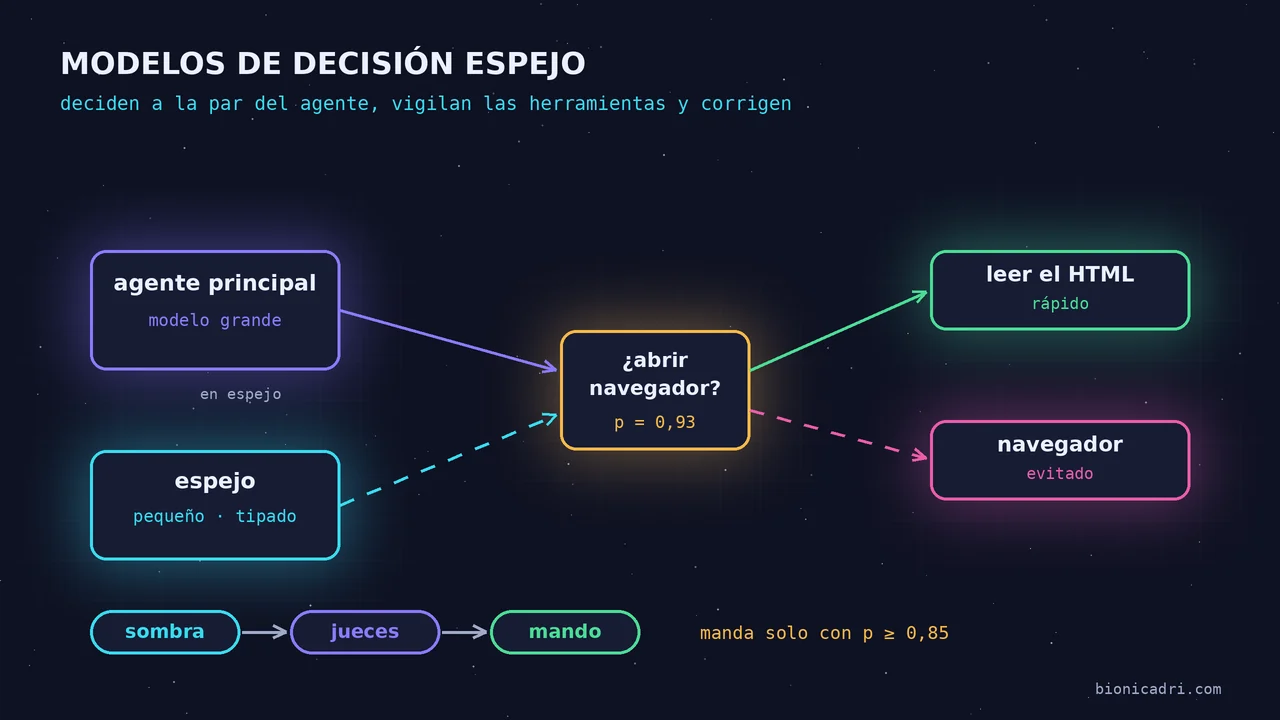
Nous avons déjà expliqué ce que sont les harnais d'ADRI et quel rôle joue le décideur. Ici, nous descendons d'un niveau : comment ce décideur « en miroir » travaille à côté de l'agent, comment il freine un outil avant qu'il ne s'exécute, quand il corrige l'agent et dans quels cas il effectue l'étape lui-même. Et comment nous le mesurons avant de lui donner du pouvoir.
Qu'est-ce qu'un modèle de décision miroir
Un agent d'ADRI prend des dizaines de petites décisions à chaque tâche. Cette page se lit-elle avec son HTML ou faut-il ouvrir un navigateur ? Cette donnée provient-elle de l'entreprise que nous cherchons ou d'une autre ? Avant, ces questions étaient résolues par des règles de mots-clés écrites dans le code.
Le modèle miroir est un petit modèle rapide qui n'écrit pas de texte. Il reçoit deux choses : l'état (ce que l'agent a devant lui) et une question typée. Il répond avec une option fermée et une probabilité. Il y a trois types de question : oui ou non, choisir une option dans une liste et donner une note. S'il y a plusieurs questions sur le même état, elles vont toutes dans un seul appel.
Le côté « typé » importe. La réponse n'est pas un paragraphe : c'est html_basta ou necesita_js, avec un 0,93 à côté. Le code la valide par rapport aux options autorisées ; si autre chose arrive, elle est rejetée.
Trois règles non négociables
- Les faits sont décidés par le code. Si un outil a été appelé, s'il a renvoyé une erreur, si un fichier existe ou quels droits a l'utilisateur : cela ne se demande à aucun modèle. Le modèle ne juge que le sens.
- En sécurité, il ne peut que durcir. Il peut baisser d'un niveau, ajouter un veto ou demander confirmation. Il ne peut jamais accorder une permission. Certaines, comme la profondeur d'un audit de sécurité, ne peuvent jamais commander.
- Rien ne commande sans être mesuré. Tout entre d'abord en mode ombre.
Comment fonctionne l'ombre
En mode ombre, le modèle miroir répond à la même question que celle à laquelle répond déjà la règle du code, mais en arrière-plan. L'agent ne l'attend pas : la latence qu'il ajoute pour l'utilisateur est nulle. En cas d'engorgement, cet échantillon est écarté au lieu de freiner la tâche.
Chaque décision est enregistrée : ce que la règle a décidé, ce que le modèle a décidé, avec quelle probabilité et combien de temps il a mis. Les données personnelles sont masquées avant de sortir. La sortie de l'agent est identique que l'ombre soit activée ou désactivée.
Ainsi, nous accumulons des milliers de cas réels, et le désaccord entre la règle et le modèle est précisément ce qu'il faut étudier.
Comment passer de l'ombre à la prise de contrôle
Décision par décision :
- Ombre avec trafic réel pendant plusieurs jours.
- Échantillon : tous les désaccords et une partie des accords.
- Juges : deux grands modèles de familles différentes étiquettent chaque cas de leur côté. Seul compte ce que les deux étiquettent de la même façon.
- Comparaison : taux de réussite de la règle face au taux de réussite du miroir lorsqu'il est sûr.
- Prise de contrôle dans une seule direction, si le miroir gagne nettement.
Lorsqu'il a le dernier mot, le miroir ne décide que si sa probabilité atteint 0,85. En dessous de ce seuil, ou s'il met trop de temps, échoue ou épuise son quota, c'est la règle habituelle qui décide. Chaque prise de contrôle se désactive séparément depuis la configuration, sans toucher au code.
Un exemple avec des chiffres. Dans l'audit SEO automatisé, le miroir décide dans quelle langue est le texte principal de chaque page. Sur 70 pages jugées le 11 octobre, la règle avait 36 % de réussite et le miroir 100 %. Depuis ce jour, sur cette question, c'est le miroir qui a le dernier mot.
Surveiller les outils avant de les exécuter
Une bonne partie des économies se trouve ici : de nombreux outils coûtent cher en temps ou en argent, et les utiliser ou non était une règle fixe.
- Ouvrir un navigateur ou le HTML suffit-il ? Dans une série réelle du 10 octobre, le code demandait un navigateur pour 52 pages ; le miroir a estimé pour 48 d'entre elles que le HTML suffisait, et 42 navigateurs ont été économisés. Ce jour-là, l'attente médiane pour obtenir un navigateur était de 142 secondes.
- Quelles sources ouvrir ? Lorsqu'on enquête sur une entreprise, le miroir classe chaque lien (site officiel, annuaire, autre chose) avant de l'ouvrir. Mesuré le 3 octobre avec du trafic réel, lorsqu'il est sûr, il atteint 97 % de réussite contre 56 % pour la règle.
- Faut-il une autre recherche ? Avant de lancer une requête supplémentaire, le miroir regarde si la donnée figure déjà dans ce qui a été rassemblé.
- Était-ce une erreur de format ? Lorsqu'un outil échoue, le système décide si l'erreur était de format afin d'apprendre à ne pas la répéter. Cette leçon est partagée entre les tâches, donc un faux « oui » la contaminerait. Ici, le miroir dispose d'un veto : il peut retirer un « oui » de la règle s'il est sûr que c'est « non », mais jamais en ajouter un.
Corriger l'agent lorsqu'il se trompe
Le miroir vérifie aussi ce que produit l'agent. Ici, nous sommes plus prudents : mal corriger est pire que ne pas corriger.
- Données d'une autre entreprise. Lorsqu'on enquête sur une entité, une donnée extraite d'une page (un CIF, un effectif, un téléphone) peut appartenir à une autre entreprise présente dans le même texte. Le miroir décide si la donnée concerne l'entité recherchée et retire celle qui ne l'est pas. Après avoir refait la question et l'état, entre le 10 et le 11 octobre, il est passé de 64 % à 91 % de réussite, sans erreurs à confiance élevée sur l'échantillon de test.
- Affirmations sans fondement. À la sortie de tous les agents, un juge vérifie si la réponse dit avoir envoyé, publié ou vérifié quelque chose que la trace des outils ne soutient pas. Aujourd'hui, il est en mode ombre : il enregistre, ne touche pas la réponse.
- Progression de la tâche. Au lieu de plafonds fixes d'appels, un contrôle décide si l'agent doit continuer, changer d'approche ou s'arrêter et livrer. Quand il sera aux commandes, il ajoutera seulement un avertissement ; il ne coupera jamais la tâche. Reste en mode ombre : dans les premières mesures, il a donné de faux « change d'approche » avec une confiance élevée.
Faire l'étape lui-même
L'objectif est que le petit modèle effectue des étapes complètes à la place du grand, uniquement là où les données le justifient.
Dans l'audit SEO, il le fait déjà : un seul appel par page répond à quatre questions (type de page, s'il s'agit d'une erreur déguisée, langue et image décorative). Sur un deuxième site web, une boutique en ligne qui n'a pas servi à écrire les questions, il a atteint 99 % de réussite sur le type de page contre 84 % pour la règle.
Dans le navigateur, il ne conduit pas encore. Nous avons déjà la question prête : quelle opération effectuer (cliquer, écrire, faire défiler, terminer…) et sur quel élément. Dans les premières mesures, il divergeait trop avec l'agent, donc nous commencerons par les étapes triviales.
Parfois, mesurer dit non. Dans le planificateur, nous avons mesuré 30 jours de tâches : le temps était dû au grand modèle en train de raisonner, pas à des étapes mécaniques. Il n'y avait rien à enlever et on ne l'a pas construit.
Combien économise-t-on ?
- Temps de bout en bout. Les 5 et 6 octobre, nous avons répété 11 tâches réelles trois fois, avec les commandes allumées et éteintes. Avec commandes, elles ont pris 863 secondes au total ; sans elles, 1 124 (23 % de moins). La qualité, jugée à l'aveugle, est restée identique. Dans des tâches très simples, les commandes ont ajouté entre 2 et 13 secondes.
- Une série de recherche. Avec la même mission, le 10 octobre, est passé de 17 minutes à 5 minutes et 46 secondes, et les appels au modèle principal de 71 à 36. Attention : cette amélioration additionne les commandes et d'autres correctifs du même jour, comme plus de navigateurs en parallèle.
- Coût du miroir lui-même. Entre le 29 septembre et le 1er octobre, 3 618 décisions ont coûté 0,043 dollar au total. Sur le serveur, chaque décision prend en moyenne environ 63 millisecondes ; en passant par notre passerelle, entre 0,3 et 0,9 seconde.
Limites et état actuel
- Le petit modèle échoue aussi. La différence est que son échec est enregistré et mesuré, et qu'en dessous du seuil, c'est la règle qui décide.
- Quand il se trompe avec assurance, il manque souvent d'informations. Si les juges ont raison avec le même texte et le miroir non, c'est l'état que nous lui donnons qui est en cause ; si le miroir doute, c'est souvent la question qui est en cause.
- La majorité reste en mode ombre. Entre le 8 et le 11 octobre, nous avons enregistré 74 points de décision. Sur notre serveur central, 16 sont aux commandes. Dans une nouvelle installation, le miroir arrive éteint et s'allume quand on décide.
- Ne remplace pas la révision. L'important continue d'être validé par une personne.
Comment nous protégeons les données en chemin, nous l'expliquons dans sécurité et conformité. Pour voir les spécialistes en action, consultez ce que fait ADRI ou essayez-le dans le chat avec ADRI.
- Agents IA
- Décisions typées
- Mode ombre
- ADRI