
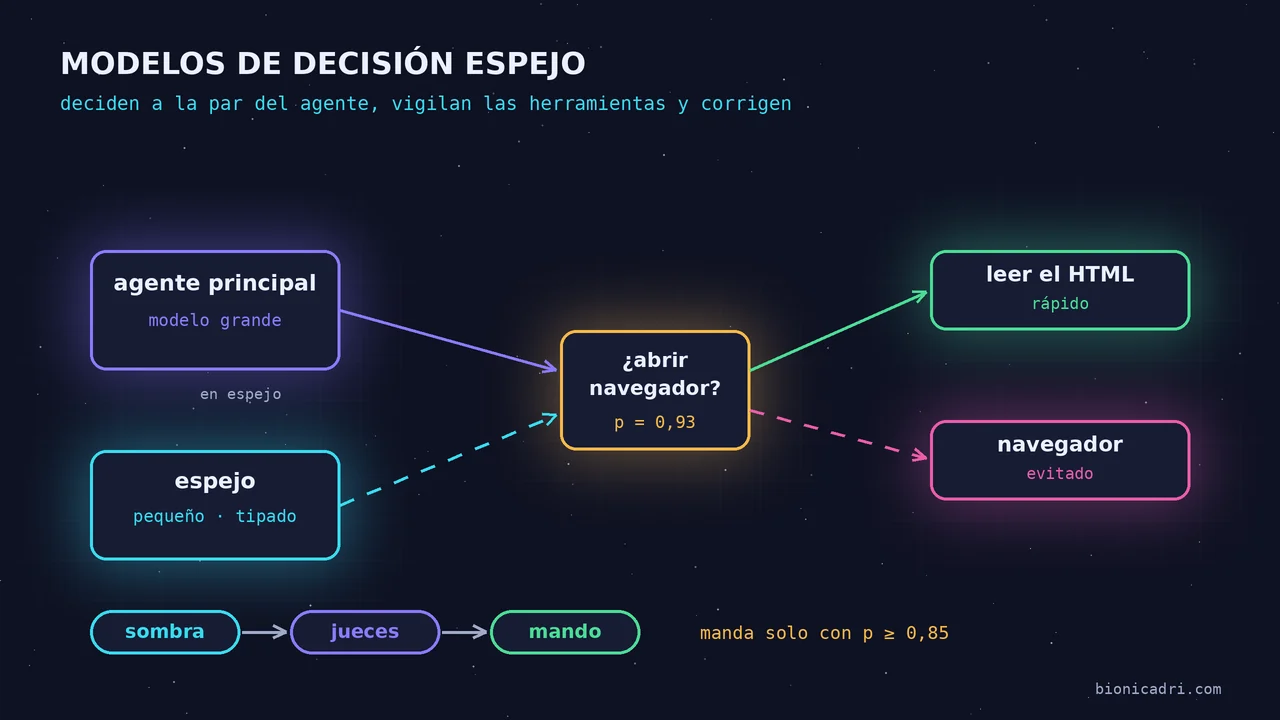
Já contámos o que são os arneses da ADRI e que papel desempenha o decisor. Aqui baixamos um nível: como trabalha esse decisor «em espelho» ao lado do agente, como trava uma ferramenta antes de ser executada, quando corrige o agente e em que casos dá o passo sozinho. E como o medimos antes de lhe dar poder.
O que é um modelo de decisão espelho
Um agente da ADRI toma dezenas de pequenas decisões em cada tarefa. Esta página lê-se com o seu HTML ou é preciso abrir um navegador? Este dado é da empresa que procuramos ou de outra? Antes, estas perguntas eram resolvidas com regras de palavras-chave escritas no código.
O modelo espelho é um modelo pequeno e rápido que não escreve texto. Recebe duas coisas: o estado (o que o agente tem à frente) e uma pergunta tipada. Responde com uma opção fechada e uma probabilidade. Há três tipos de pergunta: sim ou não, escolher uma opção de uma lista e dar uma pontuação. Se houver várias perguntas sobre o mesmo estado, vão todas numa só chamada.
O «tipada» importa. A resposta não é um parágrafo: é html_basta ou necesita_js, com um 0,93 ao lado. O código valida-a contra as opções permitidas; se chegar outra coisa, é descartada.
Três regras que não se negoceiam
- Os factos são decididos pelo código. Se uma ferramenta foi chamada, se devolveu erro, se um ficheiro existe ou que permissões tem o utilizador: isso não se pergunta a nenhum modelo. O modelo só julga o significado.
- Em segurança, só pode endurecer. Pode baixar um nível, adicionar um veto ou pedir confirmação. Nunca pode conceder uma permissão. Algumas, como a profundidade de uma auditoria de segurança, nunca podem mandar.
- Nada manda sem medir. Tudo entra primeiro em modo sombra.
Como funciona a sombra
No modo sombra, o modelo espelho responde à mesma pergunta que a regra do código já responde, mas em segundo plano. O agente não o espera: a latência que acrescenta ao utilizador é zero. Se houver congestionamento, essa amostra é descartada em vez de travar a tarefa.
Cada decisão fica registada: o que decidiu a regra, o que decidiu o modelo, com que probabilidade e quanto demorou. Os dados pessoais são ocultados antes de sair. A saída do agente é idêntica com a sombra ligada ou desligada.
Assim acumulamos milhares de casos reais, e o desacordo entre regra e modelo é exatamente o que há para estudar.
Como se passa de sombra a controlo
Vai decisão a decisão:
- Sombra com tráfego real durante dias.
- Amostra: todos os desacordos e uma parte dos acordos.
- Juízes: dois modelos grandes de famílias distintas etiquetam cada caso por sua conta. Só conta o que os dois etiquetam igual.
- Comparação: acerto da regra face ao acerto do espelho quando está seguro.
- Controlo numa única direção, se o espelho ganha com clareza.
Quando manda, o espelho só decide se a sua probabilidade chega a 0,85. Abaixo desse limiar, ou se demora demasiado, falha ou esgota a sua quota, decide a regra de sempre. Cada controlo desliga-se em separado a partir da configuração, sem tocar no código.
Um exemplo com números. Na auditoria SEO automática, o espelho decide em que idioma está o texto principal de cada página. Em cerca de 70 páginas avaliadas em 11 de outubro, a regra acertava 36 % e o espelho 100 %. Desde esse dia, nessa pergunta manda o espelho.
Vigiar as ferramentas antes de as executar
Aqui está boa parte da poupança: muitas ferramentas são caras em tempo ou em dinheiro, e usá-las ou não era uma regra fixa.
- Abrir um navegador ou basta o HTML? Numa ronda real de 10 de outubro, o código pedia navegador em 52 páginas; o espelho disse em 48 que o HTML bastava, e pouparam-se 42 navegadores. Nesse dia, a espera mediana para conseguir um navegador era de 142 segundos.
- Que fontes abrir? Ao investigar uma empresa, o espelho classifica cada link (site oficial, diretório, outra coisa) antes de o abrir. Medido em 3 de outubro com tráfego real, quando está seguro acerta 97 % contra 56 % da regra.
- É preciso outra pesquisa? Antes de lançar uma consulta adicional, o espelho verifica se o dado já está no que foi reunido.
- Foi um erro de formato? Quando uma ferramenta falha, o sistema decide se o erro foi de formato para aprender a não o repetir. Essa lição é partilhada entre tarefas, por isso um falso «sim» iria contaminá-la. Aqui o espelho tem um veto: pode retirar um «sim» da regra se tiver a certeza de que é «não», mas nunca acrescentar um.
Corrigir o agente quando erra
O espelho também revê o que o agente produz. Aqui vamos com mais cuidado: corrigir mal é pior do que não corrigir.
- Dados de outra empresa. Ao investigar uma entidade, um dado retirado de uma página (um CIF, um modelo, um telefone) pode ser de outra empresa que aparece no mesmo texto. O espelho decide se o dado é da entidade procurada e remove o que não é. Depois de refazer a pergunta e o estado, entre 10 e 11 de outubro passou de 64 % para 91 % de acerto, sem erros com confiança alta na amostra de teste.
- Afirmações sem suporte. À saída de todos os agentes, um juiz verifica se a resposta diz ter enviado, publicado ou verificado algo que o rasto das ferramentas não suporta. Hoje está em sombra: regista, não altera a resposta.
- Progresso da tarefa. Em vez de limites fixos de chamadas, um controlo decide se o agente deve continuar, mudar de abordagem ou parar e entregar. Quando mandar, apenas acrescentará um aviso; nunca interromperá a tarefa. Continua em sombra: nas primeiras medições deu falsos «muda de abordagem» com confiança alta.
Fazer o passo ele mesmo
A meta é que o modelo pequeno faça passos completos em vez do grande, apenas onde os dados o justificam.
Na auditoria SEO já o faz: uma única chamada por página responde a quatro perguntas (tipo de página, se é um erro disfarçado, idioma e imagem decorativa). Num segundo site, uma loja online que não foi usada para escrever as perguntas, acertou 99 % no tipo de página, contra 84 % da regra.
No navegador, ainda não conduz. Já temos a pergunta preparada: que operação é preciso fazer (pulsar, escrever, deslocar-se, terminar…) e sobre que elemento. Nas primeiras medições discrepava demasiado com o agente, por isso começaremos pelos passos triviais.
Por vezes, medir diz que não. No planeador, medimos 30 dias de tarefas: o tempo era o modelo grande a raciocinar, não passos mecânicos. Não havia nada para lhe retirar e não se construiu.
Quanto se poupa
- Tempo de ponta a ponta. Nos dias 5 e 6 de outubro repetimos 11 tarefas reais três vezes, com os controlos ligados e desligados. Com os controlos, demoraram 863 segundos no total; sem eles, 1.124 (23 % menos). A qualidade, avaliada às cegas, foi igual. Em tarefas muito simples, os controlos acrescentaram entre 2 e 13 segundos.
- Uma ronda de investigação. Com o mesmo pedido, em 10 de outubro passou de 17 minutos para 5 minutos e 46 segundos, e as chamadas ao modelo principal de 71 para 36. Atenção: essa melhoria soma os controlos e outras correções do mesmo dia, como mais navegadores em paralelo.
- Custo do próprio espelho. Entre 29 de setembro e 1 de outubro, 3.618 decisões custaram 0,043 dólares no total. No servidor, cada decisão demora cerca de 63 milissegundos em média; passando pelo nosso gateway, entre 0,3 e 0,9 segundos.
Limites e estado atual
- O modelo pequeno também falha. A diferença é que a sua falha fica registada e medida, e que abaixo do limiar decide a regra.
- Quando falha com confiança, costuma faltar-lhe informação. Se os juízes acertam com o mesmo texto e o espelho não, falha o estado que lhe damos; se o espelho duvida, costuma falhar a pergunta.
- A maioria continua em sombra. Entre 8 e 11 de outubro registámos 74 pontos de decisão. No nosso servidor central mandam 16. Numa instalação nova, o espelho chega desligado e liga-se quando se decide.
- Não substitui a revisão. O importante continua a ser validado por uma pessoa.
A forma como protegemos os dados ao longo do caminho é explicada em segurança e conformidade. Para veres os especialistas a trabalhar, vê o que faz a ADRI ou experimenta em o chat com a ADRI.
- Agentes IA
- Decisões tipadas
- Modo sombra
- ADRI