
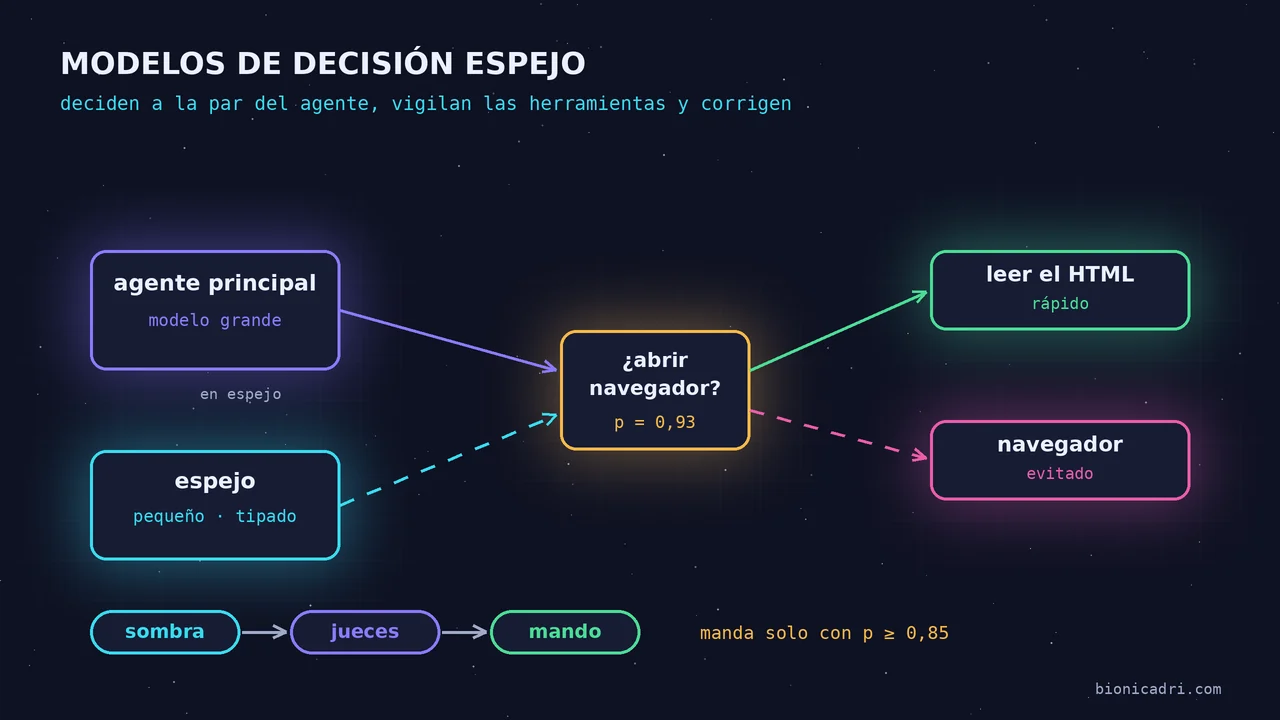
Abbiamo già raccontato cosa sono gli harness di ADRI e che ruolo gioca il decisore. Qui scendiamo di un livello: come lavora quel decisore «in specchio» accanto all'agente, come blocca uno strumento prima che venga eseguito, quando corregge l'agente e in quali casi fa il passo da solo. E come lo misuriamo prima di dargli potere.
Che cos'è un modello di decisione specchio
Un agente di ADRI prende decine di piccole decisioni in ogni attività. Questa pagina si legge con il suo HTML o serve aprire un browser? Questo dato è dell'azienda che cerchiamo o di un'altra? Prima, queste domande si risolvevano con regole di parole chiave scritte nel codice.
Il modello specchio è un modello piccolo e veloce che non scrive testo. Riceve due cose: lo stato (ciò che l'agente ha davanti) e una domanda tipizzata. Risponde con un'opzione chiusa e una probabilità. Ci sono tre tipi di domanda: sì o no, scegliere un'opzione da una lista e dare un punteggio. Se ci sono più domande sullo stesso stato, vanno tutte in una sola chiamata.
Il fatto che sia «tipizzata» conta. La risposta non è un paragrafo: è html_basta o necesita_js, con un 0,93 accanto. Il codice la valida rispetto alle opzioni consentite; se arriva qualcos'altro, viene scartata.
Tre regole non negoziabili
- I fatti li decide il codice. Se uno strumento è stato chiamato, se ha restituito errore, se un file esiste o quali permessi ha l'utente: questo non si chiede a nessun modello. Il modello giudica solo il significato.
- In sicurezza, può solo inasprire. Può abbassare un livello, aggiungere un veto o chiedere conferma. Non può mai concedere un permesso. Alcune, come la profondità di un audit di sicurezza, non possono mai dare ordini.
- Niente comanda senza essere misurato. Tutto entra prima in ombra.
Come funziona l'ombra
In modalità ombra, il modello specchio risponde alla stessa domanda a cui risponde già la regola del codice, ma in background. L'agente non lo aspetta: la latenza che aggiunge all'utente è zero. Se c'è un blocco, quel campione viene scartato invece di rallentare l'attività.
Ogni decisione viene registrata: cosa ha deciso la regola, cosa ha deciso il modello, con quale probabilità e quanto tempo ha impiegato. I dati personali vengono oscurati prima di uscire. L'output dell'agente è identico con l'ombra accesa o spenta.
Così accumuliamo migliaia di casi reali, e il disaccordo tra regola e modello è proprio ciò che va studiato.
Come si passa da ombra a comando
Procede decisione per decisione:
- Ombra con traffico reale per giorni.
- Campione: tutti i disaccordi e una parte degli accordi.
- Giudici: due modelli grandi di famiglie diverse etichettano ogni caso per conto proprio. Conta solo ciò che entrambi etichettano allo stesso modo.
- Confronto: accuratezza della regola rispetto all'accuratezza dello specchio quando è sicuro.
- Comando in una sola direzione, se lo specchio vince con chiarezza.
Quando comanda, lo specchio decide solo se la sua probabilità raggiunge 0,85. Sotto quella soglia, o se impiega troppo tempo, fallisce o esaurisce la sua quota, decide la regola di sempre. Ogni comando si disattiva separatamente dalla configurazione, senza toccare il codice.
Un esempio con i numeri. Nell'audit SEO automatico, lo specchio decide in quale lingua è il testo principale di ogni pagina. Su 70 pagine giudicate l'11 ottobre, la regola aveva un'accuratezza del 36 % e lo specchio del 100 %. Da quel giorno, su quella domanda comanda lo specchio.
Monitorare gli strumenti prima di eseguirli
Qui c'è buona parte del risparmio: molti strumenti sono costosi in tempo o denaro, e usarli o no era una regola fissa.
- Aprire un browser o basta l'HTML? In una tornata reale del 10 ottobre, il codice richiedeva un browser per 52 pagine; lo specchio ha detto per 48 che l'HTML bastava, e sono stati risparmiati 42 browser. Quel giorno, l'attesa mediana per ottenere un browser era di 142 secondi.
- Quali fonti aprire? Quando si indaga su un'azienda, lo specchio classifica ogni link (sito ufficiale, directory, altro) prima di aprirlo. Misurato il 3 ottobre con traffico reale, quando è sicuro ha un'accuratezza del 97 % rispetto al 56 % della regola.
- Serve un'altra ricerca? Prima di lanciare una query aggiuntiva, lo specchio controlla se il dato è già in quanto raccolto.
- È stato un errore di formato? Quando uno strumento fallisce, il sistema decide se l'errore è stato di formato per imparare a non ripeterlo. Quella lezione è condivisa tra le attività, quindi un falso «sì» la contaminerebbe. Qui lo specchio ha un veto: può togliere un «sì» dalla regola se è sicuro che sia «no», ma non può mai aggiungerne uno.
Correggere l'agente quando sbaglia
Lo specchio controlla anche ciò che produce l'agente. Qui andiamo con più cautela: correggere male è peggio che non correggere.
- Dati di un'altra azienda. Quando si indaga su un'entità, un dato estratto da una pagina (un CIF, un organico, un telefono) può appartenere a un'altra azienda che compare nello stesso testo. Lo specchio decide se il dato è dell'entità cercata e rimuove quello che non lo è. Dopo aver rifatto la domanda e lo stato, tra il 10 e l'11 ottobre è passato dal 64 % al 91 % di accuratezza, senza errori con alta confidenza nel campione di test.
- Affermazioni senza supporto. All'uscita di tutti gli agenti, un giudice verifica se la risposta dice di aver inviato, pubblicato o verificato qualcosa che la traccia degli strumenti non supporta. Oggi è in ombra: registra, non tocca la risposta.
- Progresso dell'attività. Invece di limiti fissi di chiamate, un controllo decide se l'agente deve continuare, cambiare approccio o fermarsi e consegnare. Quando comanderà, aggiungerà solo un avviso; non interromperà mai l'attività. Resta in ombra: nelle prime misurazioni ha dato falsi «cambia approccio» con confidenza alta.
Eseguire il passo da solo
L'obiettivo è che il modello piccolo faccia passaggi completi al posto di quello grande, solo dove i dati lo giustificano.
Nell'audit SEO lo fa già: una sola chiamata per pagina risponde a quattro domande (tipo di pagina, se è un errore mascherato, lingua e immagine decorativa). In un secondo sito web, un negozio online che non è stato usato per scrivere le domande, ha indovinato il 99 % sul tipo di pagina rispetto all'84 % della regola.
Nel browser, non guida ancora. Abbiamo già pronta la domanda: quale operazione tocca (premere, scrivere, scorrere, terminare…) e su quale elemento. Nelle prime misurazioni discordava troppo con l'agente, quindi inizieremo dai passaggi banali.
A volte misurare dice di no. Nel pianificatore abbiamo misurato 30 giorni di attività: il tempo era il modello grande che ragionava, non passaggi meccanici. Non c'era nulla da togliere e non è stato costruito.
Quanto si risparmia
- Tempo dall'inizio alla fine. Il 5 e il 6 ottobre abbiamo ripetuto 11 attività reali tre volte, con i comandi accesi e spenti. Con i comandi hanno impiegato 863 secondi in totale; senza, 1.124 (un 23 % in meno). La qualità, giudicata alla cieca, è risultata uguale. Nelle attività molto semplici, i comandi hanno aggiunto tra 2 e 13 secondi.
- Una tornata di ricerca. Con lo stesso incarico, il 10 ottobre è passato da 17 minuti a 5 minuti e 46 secondi, e le chiamate al modello principale da 71 a 36. Attenzione: quel miglioramento include i comandi e altre correzioni dello stesso giorno, come più browser in parallelo.
- Costo dello specchio stesso. Tra il 29 settembre e il 1º ottobre, 3.618 decisioni sono costate 0,043 dollari in totale. Sul server, ogni decisione impiega circa 63 millisecondi in media; passando dal nostro gateway, tra 0,3 e 0,9 secondi.
Limiti e stato attuale
- Anche il modello piccolo sbaglia. La differenza è che il suo errore resta registrato e misurato, e che sotto la soglia decide la regola.
- Quando sbaglia con sicurezza, di solito gli mancano informazioni. Se i giudici indovinano con lo stesso testo e lo specchio no, fallisce lo stato che gli diamo; se lo specchio dubita, di solito fallisce la domanda.
- La maggior parte resta in ombra. Tra l'8 e l'11 ottobre abbiamo registrato 74 punti di decisione. Sul nostro server centrale comandano 16. In un'installazione nuova, lo specchio arriva spento e si accende quando si decide.
- Non sostituisce la revisione. Ciò che conta viene ancora validato da una persona.
Come proteggiamo i dati lungo il percorso lo raccontiamo in sicurezza e conformità. Per vedere gli specialisti al lavoro, guarda cosa fa ADRI o provalo nella chat con ADRI.
- Agenti IA
- Decisioni tipizzate
- Modalità ombra
- ADRI