
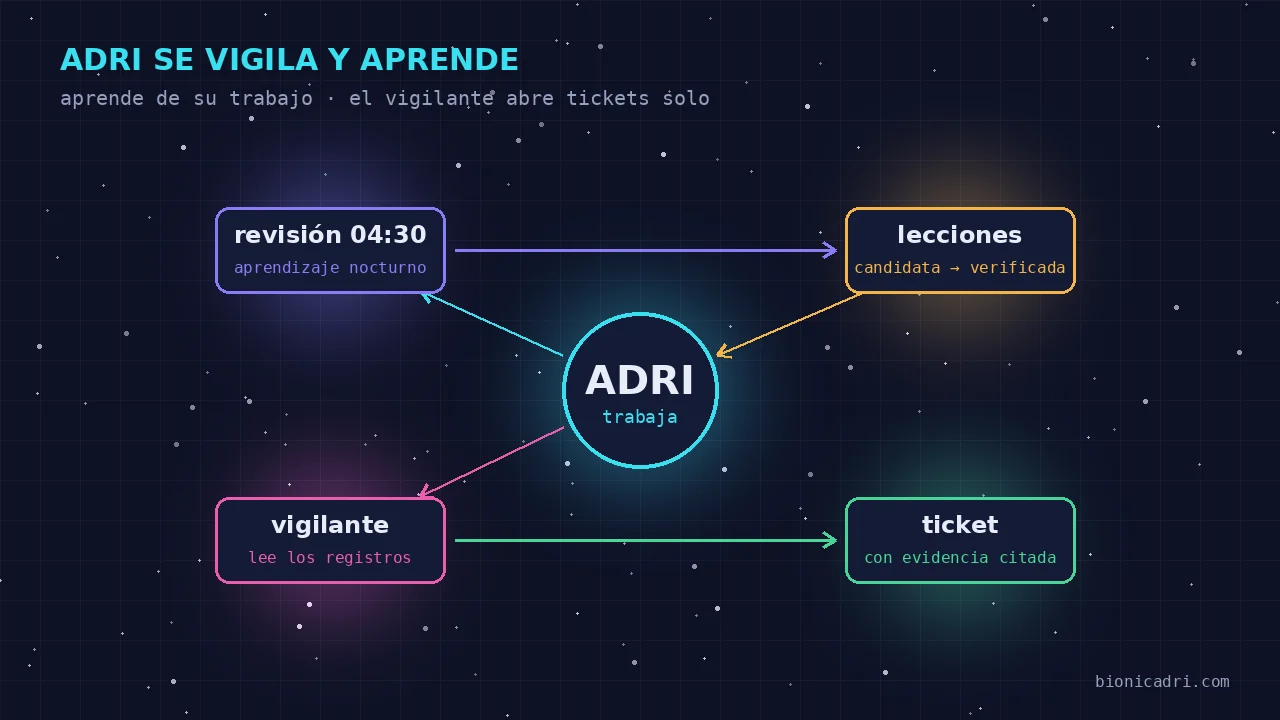
Eine KI, die jeden Tag arbeitet, macht jeden Tag Fehler. Nützlich ist, was danach passiert: ob sich der Fehler wiederholt oder ob ihn jemand erkennt und korrigiert. In ADRI gibt es dafür zwei Mechanismen, und sie funktionieren, ohne dass sich jemand daran erinnern muss.
Wir erklären, wie sie funktionieren, was du als Kunde siehst und welche Bremsen sie haben.
Die vier Arten, wie ADRI lernt
ADRI trainiert kein Modell mit deinen Daten neu. Sie speichert, ordnet und verwendet wieder, was in ihrer täglichen Arbeit passiert, auf vier verschiedene Arten.
- Was sie von dir lernt. Wenn ein Gespräch endet, geht ein kleines, schnelles Modell den Austausch durch und aktualisiert dein Profil: wie du bevorzugst, dass sie dir schreibt, welche Signatur du verwendest, welche Korrekturen du ihr gemacht hast. Dieses Profil dient dem Ton und den Vorlieben. Es dient nicht als Datenquelle: Wenn sie eine E-Mail oder den Status eines Kontos benötigt, ruft ADRI es auf der Plattform ab, statt es aus dem Gedächtnis zu holen.
- Ihr Gesprächsgedächtnis. Deine früheren Chats und die Dateien, die sie für dich erstellt hat, werden alle paar Minuten indexiert. So versteht sie „was wir zur Konkurrenz angesehen haben“, auch wenn jener Chat „Wettbewerberstudie“ hieß. Jeder Nutzer sucht nur in seinen eigenen Daten. Wenn die Suche nach Bedeutung fehlschlägt, fällt sie auf die Wortsuche zurück, statt einen Fehler auszugeben.
- Technische Lektionen. Wenn ein Werkzeug ausfällt und ADRI herausfindet, wie es zu lösen ist, oder wenn es in einer Schleife feststeckt, oder wenn du es korrigierst, kann sie eine kurze Lektion speichern wie „in diesem Fall mach dies anders“. Weiter unten erklären wir, warum eine neue Lektion nichts wert ist, bis sie sich bewiesen hat.
- Erfahrung pro Werkzeug. Der Browser zum Beispiel merkt sich, was auf jeder Website funktioniert, und vergisst alte Notizen.
Die Regel, die alles zusammenhält, ist einfach: viel speichern, wenig einspeisen. Das gespeicherte Gedächtnis kann wachsen, aber in jede Konversation gelangt nur ein kleiner, relevanter Teil. So wird keine Antwort teurer. Wir erklären es ausführlicher in wie die semantische Suche in der Wissensdatenbank funktioniert.
Die Überprüfung jeden frühen Morgens
Lernen im laufenden Betrieb sammelt Duplikate und Notizen, die nicht mehr gelten. Jeden frühen Morgen läuft eine Überprüfung, die Ordnung schafft:
- Bereinigt die Benutzerprofile. Entfernt Duplikate, löst Widersprüche auf (das Neuere gewinnt) und beschneidet.
- Überprüft den Lebenszyklus der Lektionen. Befördert die, die nachweislich funktionieren, zieht die zurück, die häufiger fehlschlagen als richtig liegen, und führt die zusammen, die dasselbe mit anderen Worten sagen.
- Zieht Lektionen zurück, die keinen Sinn mehr ergeben. Wenn sie von einem Werkzeug spricht, das ihr Agent nicht mehr hat, zieht der Code sie zurück. Es ist eine mechanische Prüfung, nicht die Meinung eines Modells, und sie ist umkehrbar.
- Erstellt eine Kopie der Lerntabellen. Eine tägliche lokale Kopie, zusätzlich zu den allgemeinen Backups.
- Speichert die Metriken der Nacht. So sieht man den Trend, statt sich auf das Bauchgefühl zu verlassen.
Es gibt einen weiteren Schritt, der heute im Testmodus ist: Ein Modell vergleicht jede Lektion mit den aktuellen Anweisungen des Agenten und schlägt vor, diejenigen zurückzuziehen, die bereits abgedeckt sind oder ihnen widersprechen. Vorerst schlägt es nur vor und hält es fest; es ändert nichts, bis wir es überprüfen. Und selbst wenn es aktiviert wird, kann es eine Lektion nur zurückziehen, wenn es den Teil der Anweisungen, der sie abdeckt, wörtlich zitiert, und niemals mehr als ein Drittel der Lektionen eines Agenten in einer Nacht.
Wie wir verhindern, dass Lernen etwas kaputt macht
Ein System, das lernt, kann nur Lügen lernen: Wenn es etwas, das schiefging, als Erfolg speichert, wird es das mit mehr Zuversicht wiederholen. Deshalb steckt fast die ganze Arbeit in den Bremsen:
- Eine Lektion beginnt als Kandidatin. Sie wird erst nach mehreren erfolgreichen Verwendungen ohne Fehler verifiziert. Wenn sie häufiger fehlschlägt als richtig liegt, wird sie zurückgezogen. Wenn sie wochenlang nicht mehr verwendet wird, ebenfalls. Wenn der Fehler, den sie korrigierte, wieder auftritt, lebt die Lektion wieder auf.
- Nur wenn sie wirklich verwendet wurde, wird sie angerechnet. Eine Lektion über ein Werkzeug zählt nur dann als Erfolg, wenn dieses Werkzeug in der Aufgabe verwendet wurde. Eine abgebrochene oder halb erledigte Aufgabe zählt weder als Erfolg noch als Fehler.
- Personenbezogene Daten raus. Die technischen Lektionen gelten für die gesamte Installation, daher werden sie vor dem Speichern zweimal von personenbezogenen Daten bereinigt.
- Die Lektionen rühren die festen Anweisungen nicht an. Sie werden als Notiz am Anfang der Anfrage hinzugefügt, höchstens die drei, die dem Fall am ähnlichsten sind. Wenn etwas schiefgeht, werden sie mit einem Schalter ausgeschaltet.
- Dein Profil kann nicht versehentlich schrumpfen. Wenn das Ergebnis beim Aktualisieren viel kürzer ausfällt als das Original, wird die Änderung verworfen. Bevor es neu geschrieben wird, wird eine Kopie gespeichert.
- Tests zahlen nicht fürs Lernen. Unsere Testbatterien haben ein Schloss, das verhindert, dass sie echte und abrechenbare Lernaufrufe auslösen.
- Du kannst es löschen. Rollen mit Berechtigung können das Gedächtnis von ADRI auf einen Schlag löschen. Standardmäßig haben es Super-Admin, Admin und Manager.
Es ist dieselbe Philosophie, die wir in den Harnessen beschreiben, die entscheiden, welches Modell arbeitet und wer prüft: Das Modell schlägt vor; der Code prüft.
Der Wächter: ein Agent, der die Logs liest
Der zweite Mechanismus lernt nicht: er wacht. Es ist ein separater Agent, der Wächter, der auf jedem Server einmal am Tag zu einer zufälligen Stunde in der Nacht läuft. Er liest, was seit dem letzten Mal in den Logs von ADRI und der Plattform geschrieben wurde, gruppiert die Fehler nach Typ und öffnet, wenn er einen echten Vorfall findet, ein Ticket in unserer zentralen Support-Installation.
| Schritt | Was passiert |
|---|---|
| 1. Lesen | Liest nur das Neue aus jedem Protokoll, ohne Abschnitte zu überspringen. |
| 2. Belege | Um ein Ticket zu öffnen, muss es wörtliche Zeilen aus dem Protokoll zitieren, und das Tool prüft, ob sie existieren. Wenn das Zitat nicht in der Datei steht, wird das Ticket abgelehnt. |
| 3. Keine Duplikate | Jeder Vorfall trägt einen Fingerabdruck. Wenn bereits ein offenes Ticket mit demselben Fingerabdruck existiert, wird kein weiteres erstellt. |
| 4. Ein gemeinsamer Fehler, ein Ticket | Wenn die Ursache in einer von mehreren Servern gemeinsam genutzten Ressource liegt, wird nur ein Ticket mit mehreren Bestätigungen geöffnet. Wenn sie lokal ist, etwa eine volle Festplatte, wird eines pro Server geöffnet, weil es unterschiedliche Probleme sind. |
| 5. Schließen | Jeden Morgen werden die Tickets des Wächters automatisch geschlossen, deren Fehler seit mehreren Tagen nicht mehr aufgetreten ist. Wenn er es nicht gut messen kann, schließt er nicht. |
Die Schritte 2 und 4 stammen aus echten Fehlern. Im Juli 2026 haben wir die sechs Tickets geprüft, die der Wächter innerhalb von zwei Tagen geöffnet hatte: Drei nannten Zähler und Namen, die in keinem Protokoll existierten. Das Modell hatte glaubhafte Vorfälle erfunden. Wir verlangen von ihm keine Ehrlichkeit: Wir verpflichten es, Zeilen zu zitieren, die das Tool suchen kann. Im selben Monat öffnete ein einziger Fehler in einer gemeinsam genutzten Ressource sieben identische Tickets, eines pro Server. Seitdem zählt das als eines.
Und was, wenn der Wächter nicht mehr durchläuft? Es gibt eine zweite Warnung: Jeden Morgen wird geprüft, wann seine letzte erfolgreiche Prüfung war. Wenn mehr als 30 Stunden vergangen sind, wird ein Ticket geöffnet, das darauf hinweist. Und wenn er hängt oder dieselbe Aktion in einer Schleife wiederholt, wird er abgebrochen.
Was du als Kunde siehst
Im Alltag: nichts. Die Tickets des Wächters landen bei unserem Support-Team, nicht in deinem Posteingang. Die Idee ist, dass wir von einem Fehler durch das Protokoll erfahren, oft bevor er dich betrifft. Wir werden nicht immer vorher da sein: Der Wächter prüft einmal am Tag, und manche Fehler fallen erst auf, wenn jemand die Funktion nutzt.
Was du jedoch merkst, ist die Wirkung des Lernens: ADRI schreibt dir in deinem Ton, erinnert sich an das, was ihr bereits besprochen habt, und wiederholt manche technischen Stolpersteine nicht mehr. Wenn du möchtest, dass deine eigenen Server Tickets mit derselben Fingerabdruck-Logik öffnen, hat die Plattform eine API: Du findest sie unter Tickets und Support mit KI.
Was es noch nicht macht
- Es repariert sich nicht von selbst. Der Wächter arbeitet im Nur-Lese-Modus. Es gibt eine zweite Phase, die dafür gedacht ist, Tickets nach der Behebung des Fehlers zu schließen, aber sie ist abgeschaltet und die automatische Reparatur hat heute keinen realen Weg. Wer repariert, ist ein Mensch.
- Es ist nicht unfehlbar. Ein Ticket des Wächters ist eine Hypothese mit Belegen, kein Fakt. Wir prüfen es, bevor wir handeln.
- Lernen ist nicht Verstehen. Eine verifizierte Lektion hat mehrmals funktioniert; sie garantiert nicht den nächsten Fall.
- Es misst, und manchmal schlägt auch die Messung fehl. Im September haben wir den eigenen Nachtzyklus auditiert und festgestellt, dass er die Nacht als gut bewertete, obwohl ein Schritt fehlschlug. Wir haben es korrigiert.
Wenn du die Liste der Agenten und ihre jeweiligen Aufgaben sehen möchtest, findest du sie unter Was ADRI macht. Um ADRI auszuprobieren, beginne mit dem Chat mit ADRI. Und wenn dich interessiert, wie wir mit den Daten umgehen, die ADRI lernt, findest du das unter Sicherheit und Compliance.
- ADRI
- Selbstlernen
- Automatische Tickets
- Monitoring